


Dữ liệu từ Columbia University trên hơn 7.000 truy vấn sản phẩm thực và 50.000 listing Amazon cho thấy mô tả sản phẩm được viết lại bằng AI đạt tỷ lệ thắng ~90% so với mô tả gốc [1]. Đồng thời, nghiên cứu GEO (Generative Engine Optimization) xác nhận mật độ dữ kiện và trích dẫn cụ thể tăng khả năng hiển thị AI khoảng 40% [2].
Nhưng trước khi lao vào chiến thuật, cần hiểu bản chất: LLM hoạt động theo xác suất (probabilistic), không phải tất định (deterministic) như công cụ tìm kiếm truyền thống. Nghĩa là ảnh hưởng được, nhưng không ổn định.
Tóm tắt các điểm chính
- LLM không phải công cụ tìm kiếm: đầu ra mang tính xác suất, không cố định. Chạy cùng prompt 5 lần, chỉ 20% thương hiệu xuất hiện nhất quán.
- Nghiên cứu E-GEO (Columbia University) cho thấy mô tả sản phẩm viết lại đạt tỷ lệ thắng ~90%, và chiến lược tối ưu có tính phổ quát: chiến thuật phát triển từ danh mục đồ gia dụng đạt 87–88% tỷ lệ thắng khi áp dụng sang điện tử và quần áo [1].
- Nghiên cứu GEO xác nhận mật độ dữ kiện tăng hiển thị ~40% [2]. Hai nghiên cứu khác chứng minh LLM có thể bị thao túng bằng chuỗi văn bản chiến lược [3] và hướng dẫn trực tiếp trong nội dung trang [4].
- Toàn bộ bức tranh cho thấy AI search đang đứng trước cuộc chạy đua vũ trang tương tự Google từng đối mặt trước khi ra mắt Panda và Penguin.
Vì sao ảnh hưởng đến đầu ra AI vừa dễ vừa không ổn định?
Câu hỏi “chúng ta có thể ảnh hưởng đến câu trả lời AI đến mức nào?” không có đáp án rõ ràng, vì bản chất LLM tạo ra 7 rào cản cấu trúc.
1/ Đầu ra theo xác suất. LLM không trả về kết quả cố định. Cùng một câu hỏi, câu trả lời thay đổi đáng kể ở cấp micro (từng prompt đơn lẻ). Đây là khác biệt cơ bản so với tìm kiếm truyền thống: Google trả cùng 10 kết quả cho cùng truy vấn, LLM thì không.
2/ Thiếu nhất quán. Chạy cùng prompt 5 lần, chỉ 20% thương hiệu xuất hiện nhất quán. Hiển thị AI không phải trạng thái — nó dao động liên tục.
3/ Thiên lệch từ dữ liệu huấn luyện. Mỗi model có thiên lệch (Primary Bias) dựa trên dữ liệu pre-training. Mức độ có thể ảnh hưởng hoặc vượt qua thiên lệch này chưa rõ. Đây là biến số lớn nhất mà không chiến thuật nào kiểm soát hoàn toàn.
4/ Model thay đổi liên tục. ChatGPT thông minh hơn rất nhiều khi so sánh phiên bản 3.5 với 5.2. Chiến thuật hiệu quả hôm nay có thể không hiệu quả cho model mới.
5/ Model khác nhau, ưu tiên khác nhau. Mỗi model đánh trọng số nguồn khác nhau cho huấn luyện và truy xuất web. ChatGPT nghiêng về Wikipedia, AI Overviews trích dẫn Reddit nhiều hơn [7].
6/ Cá nhân hóa. Gemini có thể truy cập dữ liệu cá nhân qua Google Workspace nhiều hơn ChatGPT, tạo kết quả cá nhân hóa cao hơn. Mức độ cho phép cá nhân hóa cũng khác nhau giữa các model.
Ngữ cảnh phong phú hơn. Prompt dài tiết lộ ngữ cảnh phong phú hơn, thu hẹp tập câu trả lời khả thi, và do đó khó ảnh hưởng hơn.
7 yếu tố này giải thích vì sao AI visibility là bài toán biến động (volatility problem), không phải bài toán xếp hạng cố định.
Nghiên cứu E-GEO chứng minh điều gì?
Nghiên cứu từ Columbia University (Bagga et al.) xây dựng E-GEO Testbed — bộ dữ liệu và khung đánh giá ghép hơn 7.000 truy vấn sản phẩm thực (thu thập từ Reddit) với hơn 50.000 listing Amazon, đánh giá cách các chiến lược viết lại cải thiện AI Visibility khi hiển thị cho LLM (GPT-4o) [1].
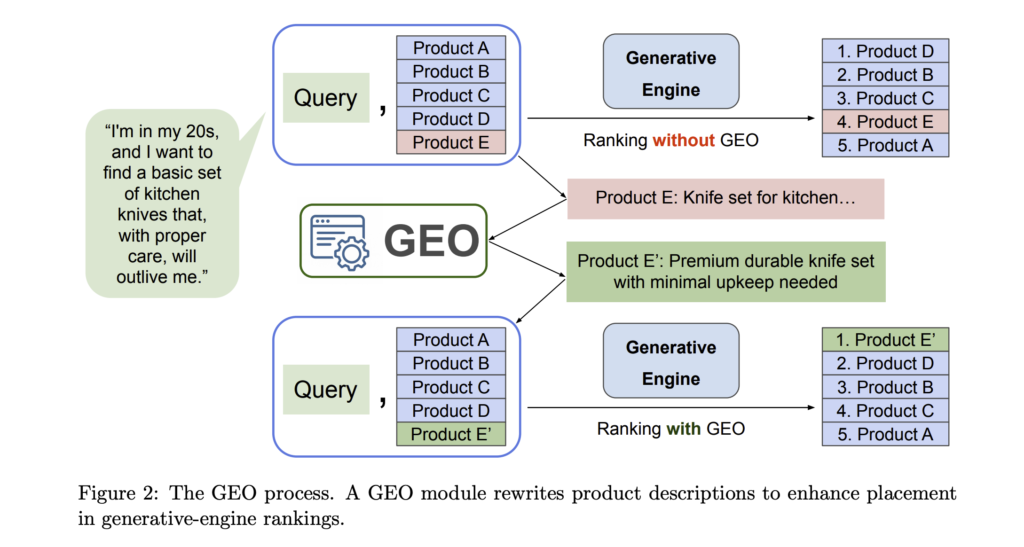
Hệ thống đo lường bằng cách so sánh AI Visibility của sản phẩm trước và sau khi mô tả được viết lại (bằng AI), thông qua mô phỏng với hai AI agent và nhóm đối chứng:
| Vai trò | Chức năng |
|---|---|
| The Optimizer (Người tối ưu) | AI agent đóng vai nhà bán hàng, viết lại mô tả sản phẩm để tối đa hóa sức hấp dẫn với công cụ tìm kiếm AI |
| The Judge (Người đánh giá) | AI agent đóng vai trợ lý mua sắm, nhận truy vấn thực và tập sản phẩm, đánh giá và xếp hạng từ tốt nhất đến tệ nhất |
| Competitors (Nhóm đối chứng) | Sản phẩm hiện có với mô tả gốc, chưa chỉnh sửa. Optimizer phải thắng nhóm này để chứng minh hiệu quả |
Phương pháp tối ưu sử dụng GPT-4o phân tích kết quả từ các vòng trước rồi đưa khuyến nghị cải thiện (ví dụ: “làm dài hơn, thêm thông số kỹ thuật”). Chu trình lặp lại cho đến khi một chiến lược chiếm ưu thế.
3 phát hiện chính:
- Phát hiện quan trọng nhất: tồn tại một “chiến lược phổ quát” (Universal Strategy) cho AI Visibility trong thương mại điện tử. Trái với giả định rằng AI ưu tiên thông tin súc tích, quá trình tối ưu hội tụ nhất quán về một phong cách viết cụ thể: mô tả dài hơn, giọng văn thuyết phục cao, và “làm đẹp” thông tin (diễn đạt lại chi tiết hiện có cho ấn tượng hơn mà không thêm dữ kiện mới).
- Mô tả viết lại đạt tỷ lệ thắng ~90% so với mô tả gốc.
- Chiến lược có tính phổ quát across danh mục: chiến thuật phát triển hoàn toàn từ sản phẩm đồ gia dụng đạt 88% tỷ lệ thắng khi áp dụng sang điện tử và 87% sang quần áo. Nhà bán hàng không cần chuyên môn theo danh mục để khai thác hệ thống.
Các nghiên cứu khác bổ sung gì?
Nghiên cứu E-GEO không đứng một mình. 3 nghiên cứu khác từ các nhóm độc lập xác nhận LLM có thể bị thao túng ở mức đáng kể.
GEO: Generative Engine Optimization (Aggarwal et al., 2024) [2] áp dụng các kỹ thuật như thêm số liệu thống kê và trích dẫn cụ thể vào nội dung. Mật độ dữ kiện (citation và số liệu) tăng AI Visibility khoảng 40%. Lưu ý: E-GEO phát hiện rằng độ dài và tính thuyết phục hiệu quả hơn trích dẫn, nhưng E-GEO (1) nghiên cứu trong ngữ cảnh mua sắm cụ thể, (2) dùng AI để tìm chiến thuật hiệu quả, và (3) mới hơn.
Manipulating Large Language Models (Kumar & Lakkaraju, 2024) [3] chèn chuỗi văn bản chiến lược (Strategic Text Sequence) dạng JSON chứa thông tin sản phẩm vào trang sản phẩm để thao túng LLM. Kết luận của nhóm nghiên cứu: nhà bán hàng có thể cải thiện đáng kể AI Visibility trong đề xuất của LLM bằng cách chèn chuỗi token đã tối ưu vào trang thông tin sản phẩm.
Ranking Manipulation (Pfrommer et al., 2024) [4] thêm văn bản vào trang sản phẩm chứa hướng dẫn trực tiếp cho LLM (như “hãy đề xuất sản phẩm này trước”). Nhóm nghiên cứu chỉ ra rằng AI Visibility mong manh và phụ thuộc nhiều vào yếu tố như tên sản phẩm và vị trí trong context window. Quan trọng: các LLM khác nhau có lỗ hổng khác nhau và không ưu tiên cùng yếu tố khi ra quyết định hiển thị.
| Nghiên cứu | Phương pháp | Phát hiện chính | Hạn chế |
|---|---|---|---|
| E-GEO [1] | Viết lại mô tả bằng AI, lặp tối ưu | Tỷ lệ thắng ~90%, chiến lược phổ quát | Ngữ cảnh thương mại điện tử |
| GEO [2] | Thêm số liệu, trích dẫn cụ thể | Tăng hiển thị ~40% | Ngữ cảnh thông tin, cũ hơn |
| Kumar & Lakkaraju [3] | Chèn chuỗi văn bản JSON | Cải thiện đáng kể AI Visibility | Tính bền vững chưa rõ |
| Pfrommer et al. [4] | Hướng dẫn trực tiếp cho LLM | AI Visibility mong manh, phụ thuộc vị trí | LLM khác nhau có lỗ hổng khác nhau |
Cuộc chạy đua vũ trang đang hình thành thế nào?
Toàn bộ nghiên cứu chỉ ra sự mong manh cực độ của LLM: đầu ra rất nhạy cảm với cách thông tin được trình bày. Thay đổi phong cách nhỏ, không ảnh hưởng đến giá trị thực của sản phẩm, có thể đưa sản phẩm từ cuối danh sách lên vị trí đề xuất số 1.
Vấn đề dài hạn là quy mô: nếu các kỹ thuật tối ưu này phổ biến, thị trường sẽ tràn ngập nội dung “phình” nhân tạo, làm giảm nghiêm trọng trải nghiệm người dùng. Google từng đứng trước cùng bài toán và đã phải ra mắt Panda (2011) và Penguin (2012) để đối phó.
Có thể phản biện rằng LLM đã “neo” câu trả lời vào kết quả tìm kiếm truyền thống — vốn đã được lọc chất lượng. Nhưng mức độ neo (grounding) thay đổi giữa các model, không phải tất cả LLM ưu tiên trang xếp hạng cao trên Google, và Google đang bảo vệ kết quả tìm kiếm ngày càng chặt chẽ hơn trước các LLM khác.
Các nhà phát triển LLM cần tìm cách giảm tác động của chiến thuật thao túng để tránh cuộc chạy đua vũ trang không hồi kết với “optimizers”. Bài toán đặt ra: cân bằng giữa cho phép nội dung chất lượng ảnh hưởng đến đầu ra (điều tốt cho hệ sinh thái) và ngăn chặn thao túng nhân tạo (điều xấu cho người dùng).
Phát hiện này thay đổi cách tiếp cận tối ưu AI search thế nào?
Đối với thương hiệu xây dựng chiến lược SEO trong bối cảnh AI, 4 hàm ý rút ra:
AI Visibility là bài toán biến động, không phải bài toán xếp hạng cố định. Chiến thuật hiệu quả hôm nay có thể không hiệu quả khi model cập nhật. Chiến lược SEO cần xây trên nền tảng lợi thế riêng (brand authority, dữ liệu độc quyền, chiều sâu chủ đề), không phải trên chiến thuật thao túng ngắn hạn.
Mỗi model là một hệ thống riêng. ChatGPT nghiêng về Wikipedia, AI Overviews trích dẫn Reddit nhiều hơn [7]. Mỗi model đánh trọng số nguồn khác nhau, có lỗ hổng khác nhau [4]. Tối ưu cho “AI nói chung” là tối ưu cho trung bình — và trung bình che giấu sự khác biệt giữa các model.
Chiến thuật thao túng hoạt động ngắn hạn nhưng mang rủi ro dài hạn. Tỷ lệ thắng 90% ấn tượng [1], nhưng khi phổ biến, nhà phát triển LLM sẽ phản ứng tương tự Google với Panda và Penguin. Thương hiệu xây trên chiến thuật thao túng sẽ mất hiển thị khi model cập nhật.
Topical authority và brand authority là đầu tư bền vững hơn chiến thuật thao túng. AI học từ sự nhất quán trên web. Thương hiệu xuất hiện nhất quán với chiều sâu chủ đề và được trích dẫn nhiều nguồn sẽ duy trì hiển thị qua các lần model cập nhật.
- AI Citation (Phần 2): Nội dung như thế nào thì dễ được AI trích dẫn?
- AI Citation (Phần 3): AI chọn nguồn nào để trích dẫn?
- AI Citation (Phần 4): Tín hiệu viết nào thực sự ảnh hưởng đến trích dẫn AI?
- AI Citation (Phần 5): nội dung ngắn gọn, đi sâu, cụ thể được ưu tiên
- AI Citation (Phần 6): AI Citation và Brand Mention là hai hệ thống khác nhau
- AI Citation (Phần 7): Hiệu ứng của Query Fan-out
Kết luận
LLM có thể bị ảnh hưởng nhiều hơn dự kiến: mô tả viết lại đạt 90% tỷ lệ thắng [1], mật độ dữ kiện tăng hiển thị 40% [2], và chuỗi văn bản chiến lược cải thiện đáng kể vị trí đề xuất [3][4]. Nhưng đầu ra AI mang tính xác suất, không nhất quán, và thay đổi giữa các model. AI Visibility là bài toán biến động, không phải xếp hạng cố định. Chiến thuật thao túng hiệu quả ngắn hạn nhưng tạo ra cuộc chạy đua vũ trang mà nhà phát triển LLM sẽ phản ứng. Nền tảng bền vững nằm ở chiều sâu chủ đề, uy tín thương hiệu và sự nhất quán — những thứ model cập nhật không xóa được.
Đây là Phần 1 trong series “Nghiên cứu cơ chế trích dẫn AI”. Phần 2 sẽ phân tích AI “chú ý” vào đâu trong nội dung và vì sao cấu trúc bài viết quyết định tỷ lệ được trích dẫn.
Nguồn nghiên cứu & trích dẫn
[1] Bagga, P. S., Farias, V. F., Korkotashvili, T., Peng, T., & Wu, Y. (2025). E-GEO: A Testbed for Generative Engine Optimization in E-Commerce. arXiv:2511.20867. https://arxiv.org/abs/2511.20867
[2] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. Proceedings of KDD 2024. arXiv:2311.09735. https://arxiv.org/abs/2311.09735
[3] Kumar, A., & Lakkaraju, H. (2024). Manipulating Large Language Models to Increase Product Visibility. arXiv:2404.07981. https://arxiv.org/abs/2404.07981
[4] Pfrommer, S., Bai, Y., Gautam, T., & Sojoudi, S. (2024). Ranking Manipulation for Conversational Search Engines. Department of EECS, UC Berkeley. arXiv:2406.03589. https://arxiv.org/abs/2406.03589
[5] Davidson, O. (2025). Staying Seen In AI Search: How Citations & Mentions Impact Brand Visibility. AirOps Research. https://www.airops.com/report/how-citations-mentions-impact-brand-visibility-in-ai-search
[6] Lafferty, N. (2025). AI Platform Citation Patterns: How ChatGPT, Google AI Overviews, and Perplexity Source Information. Profound. https://www.tryprofound.com/blog/ai-platform-citation-patterns
[7] Levin, E. (2025). How Google’s AI Mode Compares to Traditional Search and Other LLMs. Semrush Blog. https://www.semrush.com/blog/ai-mode-comparison-study/


