


Chào mừng đến với Bản tin AI Marketing, nơi các lãnh đạo phát triển số nắm bắt kịp xu hướng, đọc nhanh những chuyển biến quan trọng và định hướng chiến lược vượt.
Tuần này, chúng ta sẽ theo dõi 3 sự thay đổi lớn lao trong lĩnh vực tìm kiếm và kiểm soát giao diện:
- Tác động của ChatGPT-5
- Các yếu tố xếp hạng của Perplexity
- Cách hoạt động của Hướng dẫn Web của Google
Tác động của ChatGPT-5
ChatGPT-5 ra mắt vào ngày 7 tháng 8 năm 2025, thay thế ChatGPT-4 và các mô hình liên quan khác dành cho người dùng miễn phí và trả phí.
Thay vì cho phép người dùng lựa chọn từ nhiều mô hình, ChatGPT chỉ cung cấp tư duy GPT-5 và 5. ChatGPT-5 cũng sử dụng định tuyến thông minh, một phương pháp mà mô hình tự quyết định sử dụng suy luận hay các khả năng khác.
Sau đây là những gì đã xảy ra:
Buổi ra mắt nhận được nhiều phản ứng trái chiều:
- ChatGPT-5 vượt trội hơn ChatGPT-4 từ 15-30% về điểm chuẩn mã hóa và lập luận. Ảo giác giảm -80%! [ nguồn , nguồn ]
- Chế độ GPT-5 cơ bản tăng vọt từ 6,3% lên 24,8%, trong khi chế độ lý luận chuyên nghiệp đạt tới 89,4% đối với các truy vấn khoa học cấp độ tiến sĩ, cao hơn nhiều so với mức 70,1% của GPT-4o [ nguồn ]
- Tuy nhiên, Claude Opus 4.1 vượt trội hơn GPT‑5 trên SWE‑Bench Verified (74,5% so với ~60%), một chuẩn mực hàng đầu về khả năng mã hóa. [ nguồn ]
- Việc triển khai ChatGPT-5 gặp nhiều lỗi và nhiều người dùng bị thiếu các mô hình 4o và o3.
Tại sao tin tức này lại quan trọng:
ChatGPT-5 không phải là bước thay đổi đột phá về AGI (Trí tuệ nhân tạo tổng quát) như nhiều người vẫn nghĩ.
Về cơ bản, AGI có nghĩa là AI có khả năng suy nghĩ và học hỏi như con người.
Chúng ta chưa đến đó. Có lẽ còn chưa đến gần.
Đây là tin tốt cho chúng ta theo một số cách:
- Rủi ro thấp hơn bị AI thay thế: Mặc dù các tiêu chuẩn rất chặt chẽ, nhưng lỗi thực tế vẫn xảy ra – đòi hỏi sự giám sát biên tập của con người.
- Mô hình mạnh mẽ hơn cho công việc của chúng tôi: Với lý luận sâu sắc hơn, ít ảo giác hơn và cửa sổ ngữ cảnh rộng hơn, GPT-5 có thể tạo ra các bài đăng trên blog, sách trắng và nội dung tường thuật đáng tin cậy và mạch lạc hơn.
Dan Petrovic đã có một quan điểm hay về vấn đề này: [ nguồn ]
Ban lãnh đạo OpenAI ngày càng thể hiện rõ sự chuyển dịch chiến lược sang “trí tuệ và lập luận” trong trọng số mô hình, đồng thời dựa vào các nguồn bên ngoài hoặc truy xuất dữ liệu để có được kiến thức cập nhật. Nói cách khác, OpenAI dường như đang thiết kế các mô hình có khả năng tư duy và lập luận tốt, nhưng không cố gắng lưu trữ nội bộ tất cả kiến thức thế giới – thay vào đó, họ tận dụng các phương pháp tăng cường truy xuất (công cụ, tìm kiếm, plugin, ngữ cảnh lớn) để thu thập thông tin mới khi cần. Cách tiếp cận này được thúc đẩy bởi các cân nhắc về hiệu quả, chi phí và hiệu suất, như được chứng minh bằng các tuyên bố, nghiên cứu và phát hành sản phẩm gần đây.
Quan điểm của Infinity về vấn đề này:
Thực tế là phải mất rất nhiều nguồn lực và thời gian để phát triển và đào tạo ChatGPT-5 cho những gì chúng ta đang thấy hiện nay khiến chúng ta hy vọng rằng AI sẽ chậm lại và cho chúng ta thời gian để thích nghi.
Mức độ cá nhân hóa cao hơn trong ChatGPT-5 cho ta thấy việc hiểu rõ khách hàng (KYC) đang trở nên quan trọng hơn rất nhiều. Bằng cách đó, chúng tôi có thể mô phỏng trải nghiệm LLM của họ và tối ưu hóa nó.
Infinity thấy có sự phân chia ngày càng tăng giữa tiếp thị hiệu suất, nơi AI kết hợp quảng cáo và nội dung sáng tạo của bạn với người dùng để biến họ thành khách hàng, và tối ưu hóa khả năng hiển thị bằng AI, nơi chìa khóa để tác động đến người dùng là nội dung và sự hiện diện trên web phù hợp, do đó các LLM đề xuất bạn là giải pháp được ưu tiên.
Nhưng nếu không biết khách hàng mà chúng ta muốn tác động đến, chúng ta sẽ “tối ưu hóa trong bóng tối”.
Sau đây là những việc cần làm:
Hai điều:
- Bắt đầu thu thập càng nhiều thông tin về khách hàng càng tốt: thông tin nhân khẩu học, tâm lý học, nơi họ thường lui tới, cách họ đưa ra quyết định.
- Sử dụng ChatGPT-5 để tự động hóa quy trình làm việc, tạo/làm mới nội dung và đưa ra ý tưởng.
Các yếu tố xếp hạng sự phức tạp

Có vẻ như chúng ta có thể thiết kế ngược chương trình LLM tốt hơn chúng ta nghĩ ban đầu!
Sau đây là những gì đã xảy ra:
Metehan Yesilyurt đã phân tích các tương tác ở cấp độ trình duyệt của Perplexity và phát hiện ra một “phương án mật mã yếu” được nhúng trong các mẫu yêu cầu của nó.
59 tín hiệu được mã hóa này ảnh hưởng đến việc đánh giá và xếp hạng nội dung – những tín hiệu không thể nhìn thấy thông qua các tương tác API tiêu chuẩn.
Tại sao tin tức này lại quan trọng:
Lớp xếp hạng ẩn này giải thích lý do tại sao một số nội dung dường như hoạt động tốt ngoài mong đợi. Nó cho thấy việc có thể tối ưu hóa phù hợp với các tín hiệu cấp độ yêu cầu này có thể mang lại lợi thế cạnh tranh.
Metehan đã thử nghiệm các chiến lược tối ưu hóa phù hợp với các mô hình này và thấy được thành công – nhưng chỉ khi nội dung đã được Google lập chỉ mục.
Những nỗ lực áp dụng phương pháp này cho các trang không được lập chỉ mục đều thất bại.
Quan điểm của Infinity về vấn đề này:
Đây là bức tranh toàn cảnh: Các công cụ trả lời vốn có xu hướng tránh rủi ro.
Để đưa ra câu trả lời chắc chắn, họ phải dựa vào những nguồn có độ tin cậy rất cao. Họ không thể chấp nhận sai lầm.
Điều này tạo nên “xu hướng hướng đến chất lượng” nơi thương hiệu và uy tín quan trọng hơn bao giờ hết.
Perplexity kém xa ChatGPT và Gemini – nhưng lại ngang bằng với Claude khi nói đến số lần truy cập thuần túy.
Nó hoạt động như một lớp AI trên Tìm kiếm. Do đó, việc các yếu tố xếp hạng của Perplexity phản ánh phần nào Google Tìm kiếm là điều hợp lý.
Sau đây là những việc cần làm:
Cách tối ưu hóa cho Perplexity dựa trên những phát hiện:
- Tối đa hóa sự tương tác ngay sau khi xuất bản. Nhanh chóng tạo đà để vượt qua ngưỡng hiển thị và CTR ban đầu của hệ thống bằng cách quảng bá nội dung mới qua bản tin email, trên mạng xã hội (Linkedin, Threads, thậm chí cả Reddit nếu bạn có Subreddit riêng) và các kênh trả phí.
- Đảm bảo nội dung của bạn đáp ứng ngưỡng tương đồng khi nhúng bằng cách sử dụng ngôn ngữ phù hợp về mặt ngữ nghĩa.
- Tránh cách diễn đạt quá tối ưu hoặc gượng gạo và hãy cung cấp những thông tin chi tiết độc đáo giúp nội dung của bạn khác biệt.
Hướng dẫn web của Google hoạt động như thế nào

Andrea Volpini, CEO của Wordlift, phát hiện ra rằng cơ chế phân luồng truy vấn diễn ra ở phía máy chủ (trước khi trang tải) và được cá nhân hóa.
Có thể chọn các truy vấn phụ dựa trên lịch sử tìm kiếm, vị trí hiện tại, v.v. của người dùng.
Sau đây là những gì đã xảy ra:
Google đang thử nghiệm Web Guides , một sự kết hợp giữa AI Mode và kết quả tìm kiếm tự nhiên, giúp nhóm kết quả theo chủ đề, trong môi trường beta của Search Labs. Tính năng này được hỗ trợ bởi Gemini và tất nhiên, tận dụng phương pháp query-fan-out.
Tại sao tin tức này lại quan trọng:
Google đang đầu tư mạnh vào trải nghiệm AI – và chúng tôi không thấy có dấu hiệu nào cho thấy họ sẽ chậm lại!
Quan điểm của Infinity về vấn đề này:
Câu hỏi của chúng ta: Tại sao Google lại thấy cần phải đưa ra thứ gì đó như Web Guide?
Một lý do Infinity thấy là để cân bằng hơn giữa câu trả lời và liên kết – có thể là do phản ứng dữ dội mà Google đang phải chứng kiến gần đây.
Sau đây là những việc cần làm:
Xây dựng các nhóm nội dung mạnh mẽ dựa trên sơ đồ chủ đề ( tìm hiểu cách thực hiện ). Phương pháp tiếp cận theo chủ đề chính là những gì Web Guides (và AI Mode) phát huy tác dụng!
Kiểm tra bối cảnh SEO
Dưới đây, bạn sẽ có cái nhìn tổng quan nhanh về bối cảnh SEO hiện tại dựa trên SSI, chỉ mục trang web độc quyền của Infinity và khả năng hiển thị SEO của chúng.
Infinity thường bắt đầu phần này bằng cách so sánh 2 tuần gần nhất với 2 tuần tương tự của năm trước. Hôm nay, chúng tôi sẽ so sánh nửa đầu năm 2025 với nửa đầu năm 2024 vì chúng ta vừa hoàn thành nửa đầu năm.
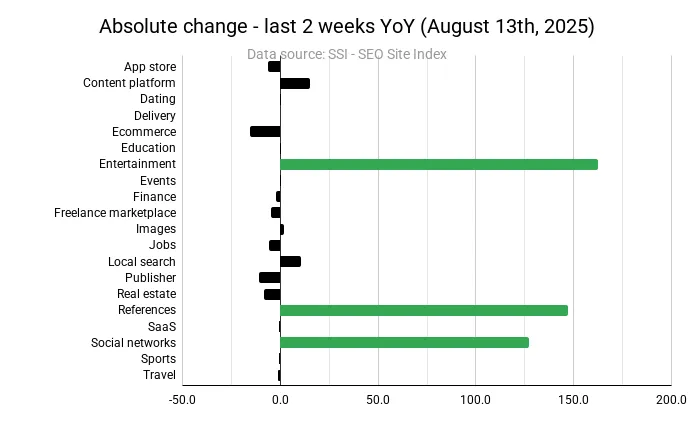
Không có nhiều thay đổi so với Bản tóm tắt về trí tuệ tăng trưởng trước đây…Vì vậy, lần này, chúng tôi muốn đưa ra một góc nhìn hơi khác một chút:
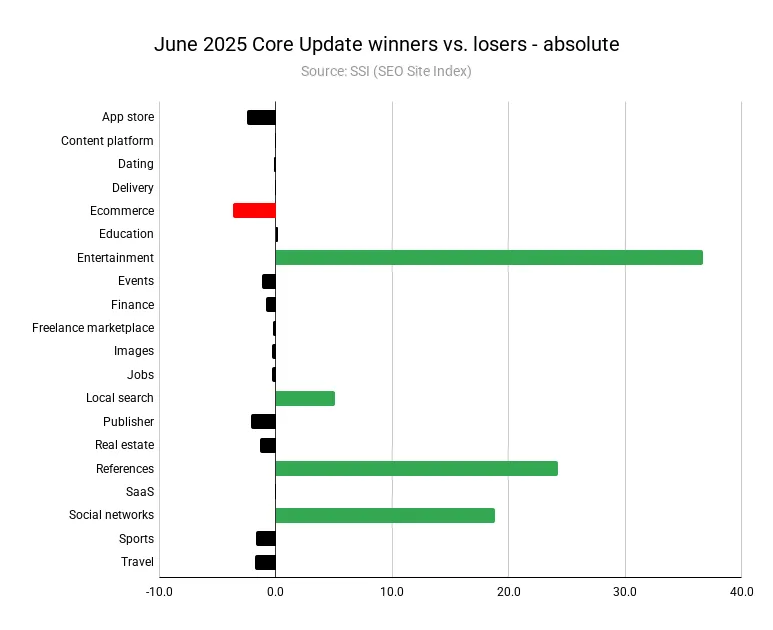
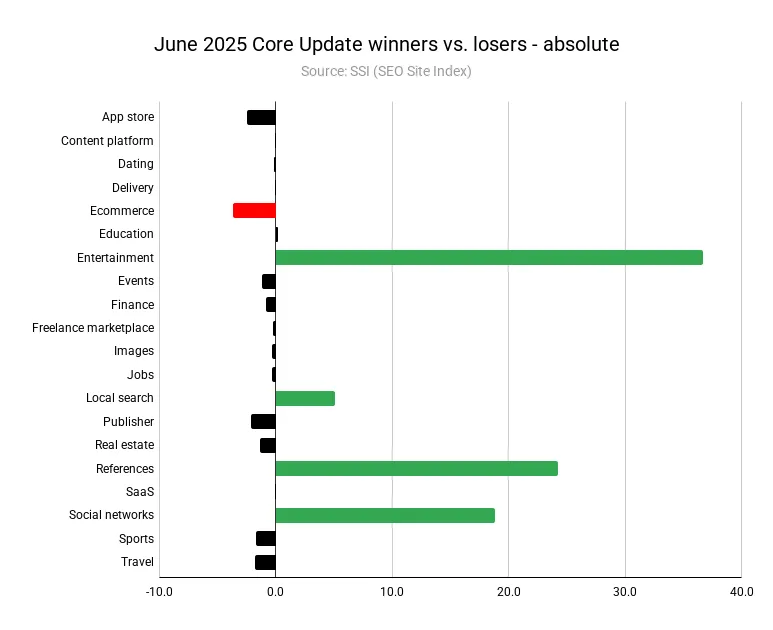
Ngành dọc nào thắng và thua nhiều nhất sau Bản cập nhật cốt lõi tháng 3 và tháng 6?
Infinity đã đo lường 4 tuần trước và sau mỗi lần triển khai.
Ngày triển khai:
- Bản cập nhật cốt lõi tháng 6: 30 tháng 6 – 16 tháng 7
- Bản cập nhật cốt lõi tháng 3: 13 tháng 3 – 26 tháng 3
Có phải các ngành dọc giống nhau đã thay đổi trong cả hai lần cập nhật không? Hoàn toàn không.
Nhưng trước tiên, dữ liệu:
Bản cập nhật cốt lõi tháng 3 năm 2025 – những thay đổi tương đối
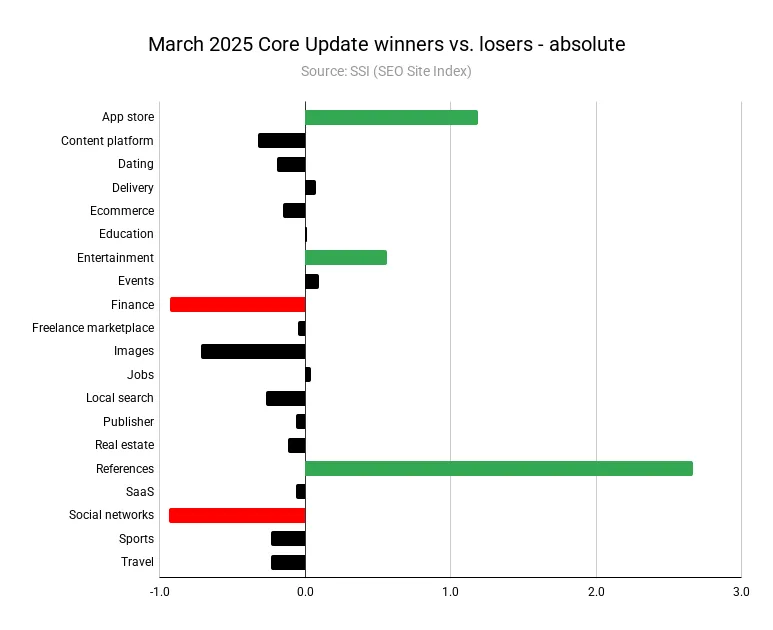
Bản cập nhật cốt lõi tháng 3 năm 2025 – những thay đổi tuyệt đối
Bản cập nhật cốt lõi tháng 6 năm 2025 – những thay đổi tương đối

Bản cập nhật cốt lõi tháng 6 năm 2025 – những thay đổi tuyệt đối
Kết luận
- Mỗi bản cập nhật sẽ thưởng và phạt những ngành khác nhau.
- App Store thắng vào tháng 3 và thua vào tháng 6. Tại sao vậy? Đây chỉ là một chiêu trò đánh lạc hướng. Cửa hàng Play của Google đã mất đi rất nhiều sự chú ý vì đã loại bỏ khoảng 50% ứng dụng do spam/chất lượng thấp.
- Tham khảo là ngành dọc duy nhất giành chiến thắng (đáng kể) trong cả hai lần cập nhật, mặc dù còn nhiều hơn thế nữa vào tháng Sáu. Động lực chính là Wikipedia, trang web lớn nhất thế giới và là nguồn mạnh nhất cho ChatGPT. Tại sao Google lại ưu tiên hiển thị nó hơn vào lúc này? Khó nói, nhưng nó đã đạt mức cao nhất mọi thời đại. Giả thuyết của chúng tôi tôi: để cân bằng với các câu trả lời AI, bởi vì mọi người thích xác minh AI trên các nguồn đáng tin cậy. Một giả thuyết khác là Google hiển thị nhiều bảng kiến thức hơn/đã phát triển hơn, làm nổi bật Wikipedia hơn.
- Giải trí đã giành chiến thắng lớn vào tháng 6, chủ yếu nhờ Youtube (+11%) và Netflix (+15%). Netflix đang thu hút lượng truy cập tự nhiên đáng kể với tạp chí Tudum (gần 10 triệu lượt truy cập hàng tháng).
- Thương mại điện tử bị ảnh hưởng trong cả hai lần cập nhật, dẫn đầu là Amazon, Best Buy và Target – tất cả đều là các nhà bán lẻ lớn. Lưu lượng truy cập không phải thương hiệu của Amazon đã giảm kể từ khoảng tháng 11 năm 2023 và gần đây họ đã gỡ bỏ toàn bộ quảng cáo khỏi Google Shopping. Target cũng bị ảnh hưởng từ lưu lượng truy cập không phải thương hiệu kể từ tháng 8 năm 2023. Chúng tôi đã viết một bài trước đây rằng Google đang giảm ưu tiên cho các nhà bán lẻ lớn trong tìm kiếm cổ điển nhưng lại ưu tiên họ trong Product Grids – nhưng giờ đây, AI Overviews đã bắt đầu thay thế Product Grids, vai trò của các công cụ tổng hợp thương mại điện tử vẫn chưa rõ ràng.
Nội dung tham khảo thêm
Những nội dung đáng chú ý trong vài ngày qua.
- Tom Warren tại The Verge đào sâu vào cách Bing chiếm thị phần từ Google.
- Các thương hiệu thường xuất hiện cùng với các thương hiệu khác trong LLM, được phát hiện bởi Nghiên cứu dữ liệu AI Chatbot của SISTRIX .
- AI phá hủy (và xây dựng lại) hào nước của thị trường như thế nào của Casey Winters.
- Wil Reynolds chia sẻ về việc đặt tên cho công việc cần làm : Không phải là AIO so với GEO hay SEO. Mà là thử nghiệm và khả năng hiển thị.


