


Nếu hóa đơn chủ yếu do output và reasoning token chi phối, nên dùng Grok 4.6, một sự hòa điểm trên Intelligence Index với giá chưa đến một phần ba là quyết định dễ dàng nhất ở đây. Nếu cần context window một triệu token hoặc công việc repository dài hạn, nên dùng GPT-5.6 Sol và chấp nhận mức giá cao hơn. Cần kiểm tra prompt của mình nằm ở phía nào so với ngưỡng phụ phí 200.000 token của Grok trước khi chuyển đổi.
Tóm tắt các điểm chính
- Năng lực gần như ngang nhau: cả hai đều đạt 61 điểm trên Intelligence Index, mỗi mô hình dẫn đầu khoảng một nửa số benchmark coding được công bố.
- Giá cả là nơi hai mô hình phân hóa rõ nhất, và không theo một tỷ lệ cố định: Sol đắt hơn 2 lần về input nhưng đắt hơn 3,3 lần về output.
- Cả hai đều tính phụ phí cho prompt dài, nhưng ngưỡng của Grok đến sớm hơn, ở mức 200.000 token so với 272.000 token của Sol.
- Trong bài test thực tế xây dựng một mô phỏng vật lý, cả hai mô hình đều tạo ra kết quả đúng và ổn định, nhưng Sol chỉ mất 3 lượt trong khi Grok cần tới 14 lượt.
- Nên chọn Grok 4.6 cho các vòng lặp nặng về reasoning và tạo sinh, chọn GPT-5.6 Sol khi cần context window 1.050.000 token, kỹ thuật nặng về terminal, hoặc muốn ít lượt nhất để hoàn thành một sản phẩm.
Tổng quan về Grok 4.6
Grok 4.6 là mô hình frontier của SpaceXAI cho coding, tác vụ agentic và công việc tri thức, ra mắt ngày 12/8/2026. Mô hình xây trên nền Grok 4.5 với trọng tâm là agent chạy dài và công việc tương tác, thị giác tham vọng hơn. SpaceXAI cho biết mô hình bám sát các tác vụ phức tạp xuyên suốt nhiều bước: nghiên cứu một chủ đề, làm việc xuyên suốt một codebase, hoặc biến một ý tưởng thành ứng dụng hoạt động được. Lượt huấn luyện bổ sung dữ liệu reasoning do mô hình tạo ra đã được tuyển chọn và reinforcement learning agentic xuyên suốt tối ưu kernel, phát triển web và thiết kế có sự hỗ trợ của máy tính.
Điểm đáng chú ý nhất là tư thế về giá: Grok 4.6 giữ nguyên mức giá 2 USD và 6 USD trên 1M input và output token của Grok 4.5 trong khi tăng 5 điểm trên Intelligence Index, điều Artificial Analysis ghi nhận là bất thường ở tầng frontier, nơi mức tăng năng lực thường đi kèm tăng giá.
Tổng quan về GPT-5.6 Sol
GPT-5.6 Sol là flagship của dòng GPT-5.6 từ OpenAI, general availability từ 9/7/2026, cùng với Terra cho công việc hàng ngày và Luna là tầng hiệu quả chi phí. OpenAI định vị Sol xoay quanh hiệu quả ngang với năng lực thô: kết quả state-of-the-art xuyên suốt coding, công việc tri thức, bảo mật mạng và khoa học trong khi dùng ít token hơn. Computer use mạnh hơn cho phép mô hình kiểm tra và tinh chỉnh kết quả đã render thay vì chỉ tạo ra code phía sau nó.
Hai nút điều chỉnh năng lực mới: chế độ max cho mô hình nhiều thời gian hơn xhigh để reasoning và sửa lại, còn ultra điều phối bốn agent song song mặc định, đánh đổi chi phí token lấy điểm số tốt hơn trong thời gian thực tế ngắn hơn. Trên Terminal-Bench 2.1, Sol Ultra đạt 91,9% so với 88,8% của Sol thường.
So sánh trực diện Grok 4.6 và GPT-5.6 Sol
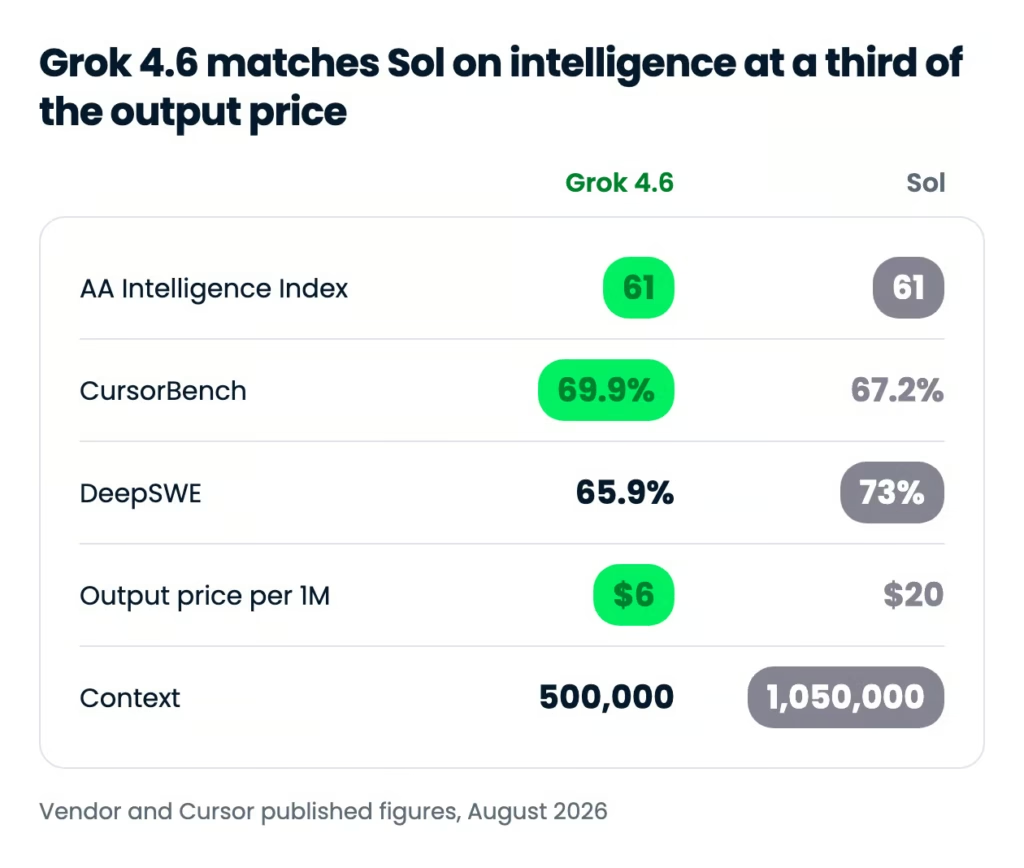
Nói ngắn gọn, hai mô hình này ngang hàng về năng lực nhưng xa lạ về giá cả.
| Yếu tố | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Ra mắt | 12/8/2026 | 9/7/2026 |
| AA Intelligence Index | 61 | 61 |
| Input/output trên 1M token | 2 USD/6 USD | 4 USD/20 USD |
| Context window | 500.000 token | 1.050.000 token |
| Ngưỡng long-context | 200.000 token | 272.000 token |
| Giá trên ngưỡng đó | 4 USD/12 USD | 2x input, 1,5x output |
| Mức reasoning | Low, medium, high, xhigh | Không có đến max, cộng ultra |
| API model ID | grok-4.6 | gpt-5.6-sol |
| Knowledge cutoff | 1/2/2026 | 16/2/2026 |
Coding và quy trình agentic
Bảng của Cursor, Grok 4.6 ở mức high đối đầu GPT-5.6 Sol ở mức max, không chỉ ra một người chiến thắng duy nhất. Grok dẫn đầu CursorBench v3.2 ở 69,9% so với 67,2% và GDPval-AA v2 ở 1753 Elo so với 1728. Sol thắng DeepSWE v1.1, 73% so với 65,9%, và Terminal-Bench v3.0, 34,6% so với 26%.
| Benchmark | Grok 4.6 (high) | GPT-5.6 Sol (max) | Ghi chú |
|---|---|---|---|
| AA Intelligence Index | 61 | 61 | Tổng hợp 9 benchmark, hòa |
| CursorBench v3.2 | 69,9% | 67,2% | Harness agent riêng của Cursor |
| DeepSWE v1.1 | 65,9% | 73% | Công việc dài hạn trên codebase thực |
| Terminal-Bench v3.0 | 26% | 34,6% | Cả hai đều thấp, khác phiên bản 2.1 của OpenAI |
| FrontierCode v1.1 Extended | 61,3% | 60,6% | Trong biên độ nhiễu |
| APEX-Agents | 57,5% | 56,7% | Trong biên độ nhiễu |
Infinity lưu ý nên đọc các khoảng cách này với sự thận trọng: mức effort không tương xứng (Grok ở high, Sol ở max), các dòng bên thứ ba là con số tự công bố hoặc công khai tốt nhất chứ không chạy trên cùng một harness, và Terminal-Bench v3.0 trong bảng của Cursor không phải Terminal-Bench 2.1 trong bài đăng của OpenAI (88,8% cho Sol), đây là hai phiên bản khác nhau.
Grok mạnh hơn trong vòng lặp agent bên trong IDE. Sol mạnh hơn ở công việc repository dài hạn và dòng lệnh.
Công việc tri thức agentic dài hạn
Grok 4.6 dẫn đầu AA-Briefcase, bộ đánh giá công việc tri thức dài hạn riêng của Artificial Analysis, ở mức 1577 Elo so với 1502 của Sol. Trên Harvey LAB, một eval tác vụ pháp lý, con số công bố là 15,8% so với 2,5%, một khoảng cách gấp 6 lần dù cả hai đều đạt điểm thấp về giá trị tuyệt đối, nên nên coi đây là một dấu hiệu cần lưu ý hơn là một khác biệt đã được xác lập chắc chắn.
Context window và công việc long-context
Sol giữ context gấp khoảng đôi: 1.050.000 token so với 500.000 của Grok 4.6, cộng giới hạn output 128.000 token mà SpaceXAI không công bố tương đương cho văn bản. Trên mức 500K không có tương đương từ Grok.
Cả hai đều tính lại giá cho prompt dài trước khi chạm trần đó, và ngưỡng của Grok đến sớm hơn: Grok 4.6 sau 200.000 token bị tính 2x input và 2x output trên toàn bộ request; GPT-5.6 Sol sau 272.000 token bị tính 2x input và 1,5x output trên toàn bộ request. Giữa mức 200.000 và 272.000, giá input của cả hai gặp nhau ở 4 USD. Grok vẫn rẻ hơn về output, nhưng với biên độ nhỏ hơn cặp giá niêm yết ban đầu gợi ý.
Kiểm soát reasoning effort
Sol cung cấp nhiều nút điều chỉnh hơn: không có đến max, cộng ultra chạy bốn agent song song. Grok 4.6 cung cấp low, medium, high làm mặc định, và xhigh. Giảm Sol xuống none cho một lượt phân loại rẻ tiền rất hữu ích. Bước nhảy Terminal-Bench 2.1 của Ultra từ 88,8% lên 91,9% là có thật, nhưng cả hai thái cực đều tính phí ở mức output gấp 3,3 lần Grok.
Bộ công cụ tích hợp sẵn
Grok 4.6 cung cấp function calling, web search, X search và code execution. GPT-5.6 Sol thêm file search, tạo ảnh, code interpreter, một hosted shell, apply patch, computer use và tool search trên Responses API. Sol cũng có Programmatic Tool Calling: mô hình viết và chạy một chương trình nhỏ điều phối tool và lọc kết quả trung gian thay vì đưa mọi phản hồi tool qua lại với mô hình.
Giá thực tế của Grok 4.6 và GPT-5.6 Sol là bao nhiêu?
Giá cả là khác biệt rõ ràng nhất, và hình dạng của nó không phải một tỷ lệ cố định.
| Mức phí | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Input, trên 1M token | 2,00 USD | 4,00 USD |
| Output, trên 1M token | 6,00 USD | 20,00 USD |
| Đọc cached input, trên 1M token | 0,50 USD | 0,40 USD |
| Ngưỡng long-context | 200.000 prompt token | 272.000 input token |
| Trên ngưỡng đó | 2x input và output | 2x input, 1,5x output |
| Biến thể Fast, input/output | 4,00 USD/12,00 USD | Không áp dụng |
Sol đắt gấp 2 lần về input nhưng gấp 3,3 lần về output, nên khoảng cách nới rộng theo mọi thứ mô hình viết ra. Reasoning token tính theo giá output ở cả hai. Đọc cache gần nhau (0,50 USD so với 0,40 USD), nhưng SpaceXAI cảnh báo nếu không có prompt_cache_key trên Responses API, thường phải trả đầy đủ giá input trên một server cache-cold.
Một khối lượng công việc thực tế tốn bao nhiêu?
| Khối lượng công việc | Grok 4.6 | GPT-5.6 Sol | Chênh lệch |
|---|---|---|---|
| Generation-heavy: 1M in/4M out | 26 USD | 84 USD | +58 USD (223%) |
| Retrieval, dưới ngưỡng: 10M in/1M out | 26 USD | 60 USD | +34 USD (131%) |
| Retrieval, vượt ngưỡng: 10M in/1M out | 52 USD | 110 USD | +58 USD (112%) |
Generation-heavy chính là nơi khoảng cách giá output thể hiện rõ nhất. Hai dòng retrieval cùng khối lượng 10M in/1M out, chỉ khác nhau ở việc mỗi request có vượt cả hai ngưỡng hay không, nên chênh lệch giữa hai dòng chính là phụ phí. Hóa đơn của Grok tăng gấp đôi từ 26 USD lên 52 USD ở dòng đó. Sol tăng từ 60 USD lên 110 USD. Mức phụ trội tương đối thu hẹp từ 131% xuống 112% ngay cả khi khoảng cách USD tăng lên.
Grok 4.6 và GPT-5.6 Sol hoạt động thế nào trong bài test thực tế?
Infinity chạy một tác vụ xây dựng khó cho cả hai mô hình trong cùng một coding agent.
Bài test: xây dựng một trang HTML một file (CSS và JS inline, canvas, không build step, không thư viện ngoài, không mạng) mô phỏng vài chục quả bóng kích thước khác nhau nảy trong một container hình vuông xoay chậm, dưới trọng lực. Các quả bóng va chạm với nhau và với tường container, mất một chút năng lượng mỗi lần va chạm để hệ thống lắng xuống thay vì tăng năng lượng theo thời gian.
Cả hai đều chạy trong Cursor ngày 25/8/2026: Grok 4.6 ở mức reasoning high, GPT-5.6 Sol ở mức reasoning high. Mạng bị từ chối cho cả hai.
Grok 4.6 tạo ra một file index.html hoạt động được, vượt qua kiểm tra chạy được: một file duy nhất, tự chạy hoạt hình khi tải, không có lỗi console chưa bắt được, vẫn chạy sau 30 giây. Việc chứa bóng giữ vững khi hộp xoay, va chạm bóng với bóng trông hợp lý, hệ thống mất năng lượng và lắng xuống thay vì tăng tốc. Việc này tốn 14 lượt trợ lý, với nhiều vòng tự sửa lỗi. Mô hình cũng yêu cầu quyền truy cập trình duyệt để tự kiểm tra công việc, yêu cầu này bị từ chối theo quy tắc quyền hạn của bài test.
GPT-5.6 Sol cũng vượt qua kiểm tra chạy được và đạt cùng điểm 5 về độ đúng vật lý và 5 về độ ổn định. Container của Sol xoay chậm hơn Grok, khiến hiệu ứng sóng sánh và tái xếp chồng dễ theo dõi hơn, đây là trục duy nhất Sol vượt trội về chất lượng hình ảnh. Sol đạt kết quả này chỉ trong 3 lượt và nhìn chung nhanh hơn Grok nhiều.
| Chỉ số | Grok 4.6 (high) | GPT-5.6 Sol (high) |
|---|---|---|
| Số lượt | 14 | 3 |
| Chạy được | Đạt | Đạt |
| Độ đúng vật lý | 5 | 5 |
| Độ ổn định theo thời gian | 5 | 5 |
| Chất lượng hình ảnh | 4 | 5 |
| Tổng thể | 3,5 | 5 |
Về sản phẩm cuối, đây gần như một trận hòa: cả hai đều đúng vật lý và đều ổn định. Sự phân hóa nằm ở nỗ lực: Sol đạt cùng kết quả trong 3 lượt so với 14 lượt của Grok, đây chính là điều kéo điểm tổng thể của Grok xuống 3,5. Cần nhớ đây chỉ là n=1 trên một bài xây dựng trực quan, nên nên đọc như một điểm dữ liệu, không phải một benchmark, và không nói lên điều gì về codebase lớn hay chuỗi truy xuất dài.
Khi nào nên chọn Grok 4.6, khi nào nên chọn GPT-5.6 Sol?
Vì năng lực gần ngang nhau, quyết định quy về hình dạng khối lượng công việc, kích thước context, và mức độ quan tâm đến số lượt so với chi phí trên mỗi token.
Nên chọn Grok 4.6 nếu: khối lượng công việc viết ra nhiều, ở mức 6 USD trên 1M output token so với 20 USD của Sol, một tháng generation-heavy tốn 26 USD thay vì 84 USD; prompt luôn dưới 200.000 token, đây là nơi giá 2 USD và 6 USD của Grok áp dụng đầy đủ; công việc agent diễn ra bên trong một IDE, Grok dẫn đầu CursorBench v3.2 ở 69,9% và là mô hình mặc định trong Grok Build; quan tâm đến chi phí trên mỗi token hơn số lượt.
Nên chọn GPT-5.6 Sol nếu: cần hơn 500K token context, cửa sổ 1.050.000 token của Sol không có tương đương từ Grok 4.6; agent làm việc dài hạn trên repository thực, mức 73% của Sol trên DeepSWE v1.1 so với 65,9% của Grok là khoảng cách coding lớn nhất theo bất kỳ hướng nào; số lượt quan trọng hơn giá token, Sol hoàn thành bài test vật lý trong 3 lượt so với 14 lượt của Grok; muốn kiểm soát tinh chỉnh hơn về mức effort, Sol chạy từ none đến max và thêm ultra.
Bắt đầu dùng Grok 4.6 và GPT-5.6 Sol như thế nào?
Cả hai mô hình chỉ cần đổi một chuỗi nếu đã gọi một endpoint tương thích OpenAI. Chuỗi đó là grok-4.6 và gpt-5.6-sol.
| Kênh truy cập | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| API chính thức | xAI API | OpenAI API |
| Ứng dụng người dùng | Grok app và Grok.com | ChatGPT |
| Coding agent | Grok Build (mô hình mặc định), Cursor (mọi gói) | Codex, Cursor |
| Gateway mô hình | OpenRouter, Vercel, Cloudflare | OpenRouter, Vercel, Cloudflare |
| API model ID | grok-4.6 | gpt-5.6-sol |
Trong Cursor, cả hai mô hình đều nằm trong bộ chọn, chuyển đổi chỉ là thay đổi lựa chọn, không cần viết lại cấu hình. Qua API, việc thay thế chỉ là một chuỗi, xAI phục vụ một endpoint tương thích OpenAI.
Kết luận
Trong bài test thực tế, các tuyên bố ra mắt đứng vững: cả hai mô hình đều pass với kết quả tốt. Tuy nhiên Sol nhanh hơn Grok nhiều và chỉ mất khoảng 20% số lượt của Grok, cho thấy một khoảng cách đáng kể.
Câu hỏi thường gặp
Grok 4.6 có tốt hơn GPT-5.6 Sol không?
Không mô hình nào thắng tuyệt đối. Cả hai hòa ở 61 điểm trên Artificial Analysis Intelligence Index, mỗi mô hình dẫn đầu khoảng một nửa số benchmark coding công bố: Grok 4.6 thắng CursorBench v3.2 (69,9% so với 67,2%) trong khi GPT-5.6 Sol thắng DeepSWE v1.1 (73% so với 65,9%) và Terminal-Bench v3.0 (34,6% so với 26%). Trong bài test xây dựng mô phỏng vật lý một file, cả hai đều tạo ra kết quả đúng, ổn định. Khác biệt nằm ở nỗ lực: Sol hoàn thành trong 3 lượt, Grok mất 14 lượt.
Grok 4.6 và GPT-5.6 Sol có giá bao nhiêu?
Grok 4.6 có giá 2 USD trên 1M input token và 6 USD trên 1M output token. GPT-5.6 Sol có giá 4 USD input và 20 USD output. Đọc cached input là 0,50 USD cho Grok và 0,40 USD cho Sol. Tỷ lệ không đồng nhất: Sol đắt gấp 2 lần về input nhưng gấp 3,3 lần về output, nên khoảng cách nới rộng theo mọi thứ mô hình viết ra. Cả hai đều tính lại giá cho prompt dài, Grok từ 200.000 token (4 USD input và 12 USD output), Sol trên 272.000 input token (2x input, 1,5x output), áp dụng cho toàn bộ request trong mỗi trường hợp.
API model ID của Grok 4.6 và GPT-5.6 Sol là gì?
Chuỗi là grok-4.6 cho SpaceXAI và gpt-5.6-sol cho OpenAI. OpenAI cũng định tuyến alias gpt-5.6 đến Sol. Vì API xAI tương thích OpenAI, chuyển đổi giữa hai bên chỉ là đổi một chuỗi cộng đổi base URL sang https://api.x.ai/v1.
Grok 4.6 hay GPT-5.6 Sol có context window lớn hơn?
GPT-5.6 Sol giữ 1.050.000 token so với 500.000 của Grok 4.6, kèm giới hạn output 128.000 token, trong khi SpaceXAI không công bố giới hạn output văn bản. Cả hai mô hình đều tính phí cao hơn cho prompt dài, ngưỡng của Grok đến trước ở mức 200.000 token so với 272.000 của Sol. Giữa hai mốc đó, Grok bị phụ phí trong khi Sol thì không, khiến giá input của cả hai ngang nhau ở mức 4 USD trên 1M.
Có thể truy cập Grok 4.6 và GPT-5.6 Sol ở đâu?
Truy cập Grok 4.6 qua API xAI hoặc Grok Build, và GPT-5.6 Sol qua API OpenAI hoặc Codex. Cả hai cũng truy cập được qua Cursor và OpenRouter, hoặc qua các gateway AI như Vercel hoặc Cloudflare.


