


Phân tích 1,2 triệu câu trả lời từ ChatGPT cho thấy AI không đọc nội dung web theo cách viết truyền thống. Thay vì kiên nhẫn đọc từ đầu đến cuối như một độc giả, ChatGPT hoạt động giống một biên tập viên bận rộn: nó lướt nhanh, lấy thông tin quan trọng nhất từ phần đầu, rồi chỉ quay lại những đoạn nào chứa dữ liệu có giá trị cao. Nghiên cứu này của Infinity xác định chính xác vị trí AI trích dẫn trên trang và 5 đặc điểm ngôn ngữ giúp nội dung được chọn.
Đây là phần 2 trong series “Nghiên cứu cơ chế trích dẫn AI” (Science of AI Citation). Phần 1 đã thiết lập tiền đề rằng output của AI có thể bị tác động, với tỷ lệ thắng lên đến 90% khi tối ưu mô tả sản phẩm. Phần 2 này đi sâu vào câu hỏi tiếp theo: nếu AI có thể bị tác động, thì cơ chế đọc của nó hoạt động ra sao?
Tóm tắt các điểm chính
- Mô hình “ski ramp”: 44,2% trích dẫn ChatGPT đến từ 30% đầu nội dung. Phần cuối trang gần như vô hình với AI.
- AI đọc sâu từng đoạn: 53% trích dẫn lấy từ câu giữa đoạn văn, không phải câu đầu. AI tìm câu có information gain cao nhất.
- 5 đặc điểm ngôn ngữ giúp được trích dẫn: ngôn ngữ khẳng định, cấu trúc hỏi-đáp, mật độ thực thể ~20%, sắc thái cân bằng (subjectivity ~0,47), văn phong chuyên nghiệp cấp doanh nghiệp.
- Kết quả có ý nghĩa thống kê tuyệt đối: P-value = 0,0 trên 1,2 triệu mẫu, xác nhận qua 4 batch kiểm định chéo.
- Viết cho AI khác viết cho SEO truyền thống: cần front-load thông tin quan trọng thay vì xây dựng dần đến kết luận.
ChatGPT trích dẫn từ vị trí nào trên trang web?
Mô hình “ski ramp” (dốc trượt tuyết) là phát hiện trung tâm của nghiên cứu này. Từ 18.012 trích dẫn đã xác minh, Infinity nhận thấy ChatGPT phân bổ sự chú ý không đều trên trang web, với sự tập trung lệch hẳn về phần đầu.
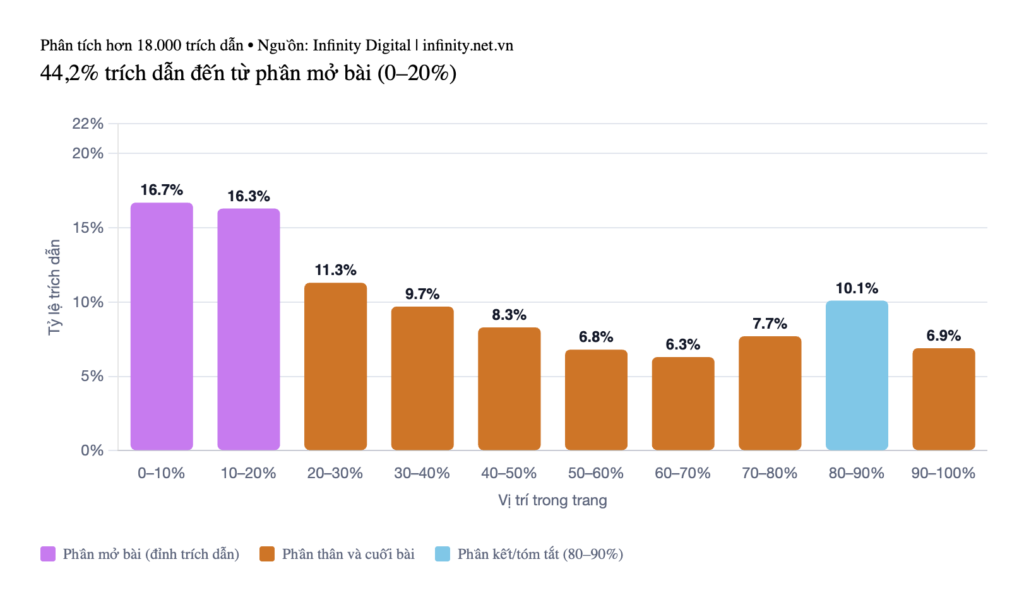
Cụ thể, phân bổ trích dẫn theo vị trí trên trang như sau:
| Vị trí trên trang | Tỷ lệ trích dẫn | Ý nghĩa |
|---|---|---|
| 30% đầu (phần mở) | 44,2% | AI lấy thông tin “Ai, Cái gì, Ở đâu” từ đây |
| 30–70% (phần giữa) | 31,1% | Nội dung chôn sâu ở đoạn 12/20 bị bỏ qua gấp 2,5 lần |
| 70–100% (phần cuối) | 24,7% | AI “tỉnh lại” ở phần tổng kết, nhưng bỏ qua footer |
Mô hình ski ramp phản ánh hai yếu tố cơ bản trong cách LLM xử lý văn bản. Thứ nhất, dữ liệu huấn luyện của các mô hình ngôn ngữ lớn chủ yếu đến từ báo chí và bài nghiên cứu học thuật, cả hai đều tuân theo cấu trúc BLUF (Bottom Line Up Front, đặt kết luận lên đầu). Mô hình học được rằng thông tin có trọng số cao nhất luôn nằm ở phần đầu văn bản. Thứ hai, dù các mô hình hiện đại có thể xử lý tới 1 triệu token trong một lần tương tác (tương đương 700.000–800.000 từ), chúng vẫn ưu tiên thiết lập “khung nhận thức” (frame) càng nhanh càng tốt, sau đó diễn giải toàn bộ nội dung còn lại thông qua khung đó.
Điều này có ý nghĩa trực tiếp đối với người viết nội dung: nếu insight quan trọng nhất nằm ở phần mở đầu, xác suất được AI trích dẫn tăng đáng kể. Ngược lại, nếu tính năng sản phẩm hoặc dữ liệu then chốt bị chôn ở đoạn 12 trong một bài 20 đoạn, AI có khả năng bỏ qua nó cao gấp 2,5 lần.
Mô hình ski ramp có đáng tin cậy không?
Mô hình ski ramp đạt mức ý nghĩa thống kê tuyệt đối với P-value = 0,0 (p < 0,0001), nghĩa là kết quả này không phải do ngẫu nhiên. Để kiểm chứng thêm, Infinity chia 18.012 trích dẫn thành 4 batch ngẫu nhiên (randomized validation splits) và phân tích riêng từng batch.
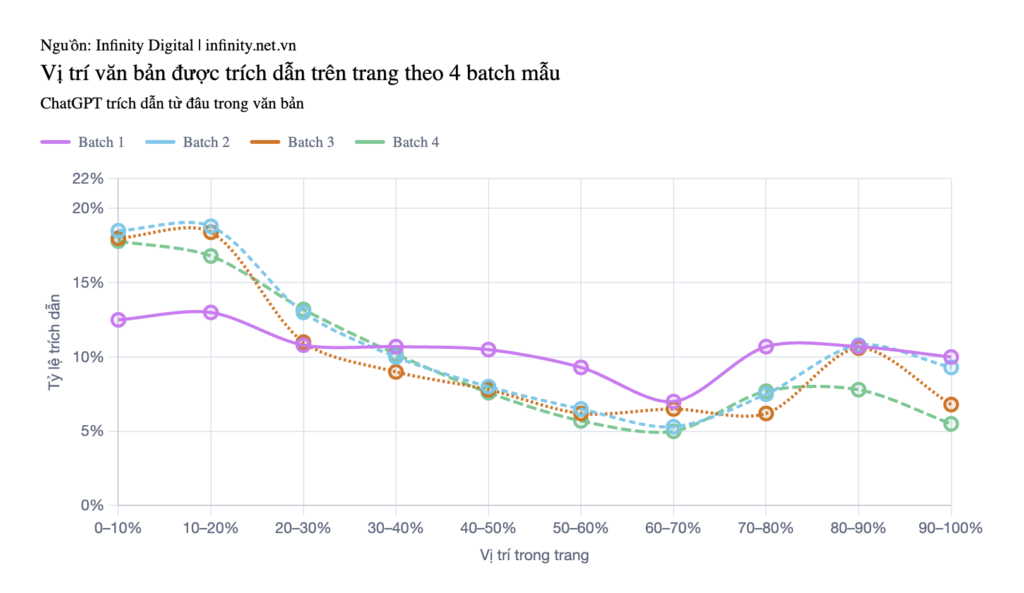
Batch 1 phẳng hơn một chút, nhưng batch 2, 3 và 4 cho ra phân bổ gần như đồng nhất. Kết quả này xác nhận rằng mô hình ski ramp ổn định xuyên suốt 1,2 triệu trích dẫn, không phải hiện tượng cục bộ hay sai lệch do chọn mẫu.
Tuy nhiên, tính ổn định ở cấp vĩ mô (toàn trang) đặt ra một câu hỏi mới ở cấp vi mô: liệu xu hướng ưu tiên phần đầu có tiếp tục khi AI đọc sâu vào từng đoạn văn, hay cơ chế chú ý thay đổi ở cấp độ granular hơn?
AI đọc từng đoạn văn như thế nào?
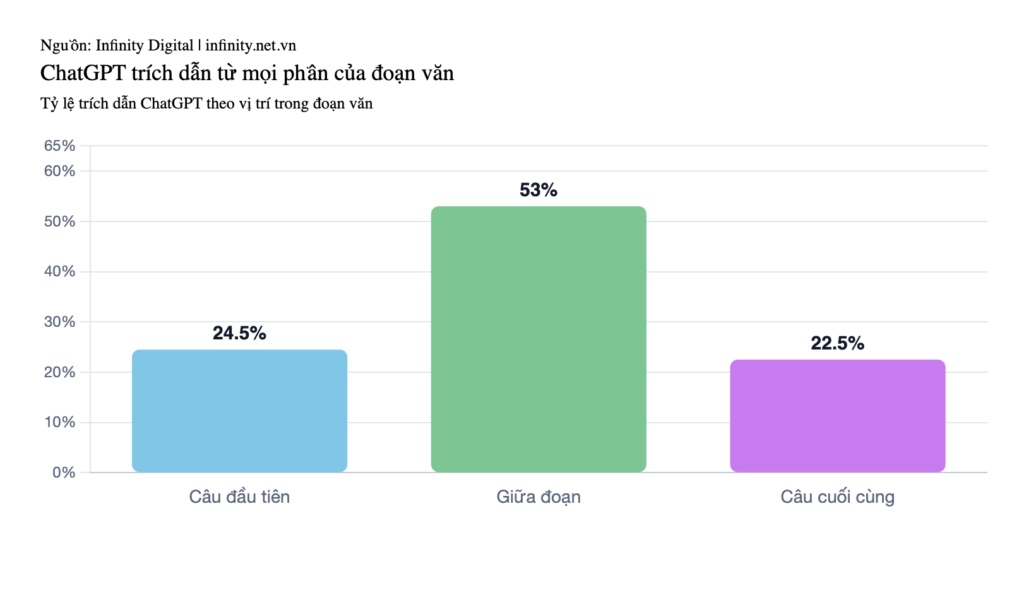
53% trích dẫn ChatGPT đến từ câu giữa đoạn văn, không phải câu đầu hay câu cuối. Phân tích chuyên sâu trên 1.000 bài viết có lượng trích dẫn cao cho thấy một phát hiện đáng chú ý: AI không “lười biếng” chỉ đọc câu đầu tiên của mỗi đoạn.
| Vị trí trong đoạn văn | Tỷ lệ trích dẫn |
|---|---|
| Câu đầu | 24,5% |
| Câu giữa | 53,0% |
| Câu cuối | 22,5% |
Phát hiện này bổ sung cho mô hình ski ramp chứ không mâu thuẫn với nó. Ở cấp vĩ mô (toàn trang), AI tập trung vào vùng đầu. Nhưng khi đã vào một đoạn văn, nó không dừng ở câu mở đầu mà tìm câu có “information gain” (mức gia tăng thông tin) cao nhất. Information gain ở đây là câu sử dụng đầy đủ nhất các thực thể liên quan (entity) và bổ sung thông tin mới, mở rộng hiểu biết của người đọc thay vì lặp lại điều đã biết.
Kết hợp cả hai phát hiện, kết luận thực tế là: xác suất được trích dẫn cao nhất thuộc về các câu giàu thông tin nằm trong những đoạn văn ở 20% đầu trang. Người viết không cần ép câu trả lời vào dòng đầu tiên của mỗi đoạn, nhưng cần đảm bảo rằng các đoạn văn quan trọng nhất nằm gần đầu bài.
Những đặc điểm ngôn ngữ nào giúp nội dung được ChatGPT trích dẫn?
5 đặc điểm ngôn ngữ phân biệt rõ ràng giữa nội dung được trích dẫn và nội dung bị bỏ qua. Sau khi xác định AI trích dẫn từ đâu trên trang, nghiên cứu chuyển sang phân tích “DNA ngôn ngữ” (linguistic DNA) của 11.022 trích dẫn để trả lời câu hỏi: điều gì khiến một đoạn văn cụ thể được chọn thay vì đoạn khác? 5 đặc điểm đó là ngôn ngữ khẳng định, cấu trúc hỏi-đáp, mật độ thực thể cao, sắc thái cân bằng và văn phong chuyên nghiệp.
Tại sao ngôn ngữ khẳng định được AI ưu tiên trích dẫn?
Nội dung được trích dẫn có khả năng chứa ngôn ngữ khẳng định cao gấp gần 2 lần (36,2% so với 20,2%) so với nội dung bị bỏ qua. Ngôn ngữ khẳng định ở đây là các cụm từ xác định rõ ràng mối quan hệ giữa các khái niệm, chẳng hạn “X là Y”, “X được định nghĩa là”, “X đề cập đến”. Không nhất thiết phải viết một định nghĩa từ điển, nhưng quan hệ giữa chủ thể và thuộc tính cần rõ ràng, không mơ hồ.
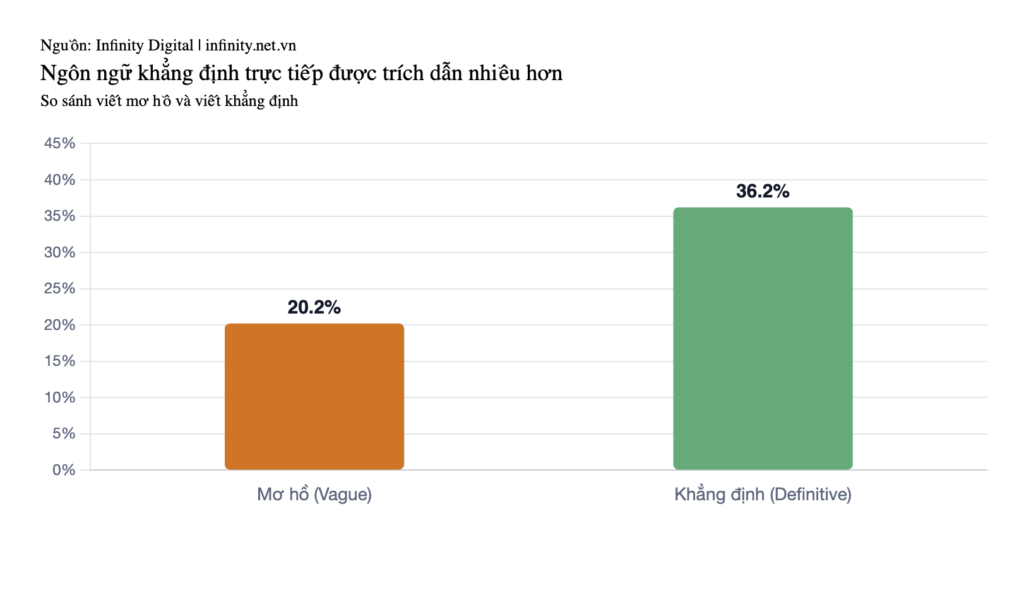
Có hai giải thích kỹ thuật cho hiện tượng này. Trong cơ sở dữ liệu vector, từ “là” (is) hoạt động như một cầu nối mạnh kết nối chủ thể với định nghĩa. Khi người dùng hỏi “X là gì?”, mô hình tìm đường vector mạnh nhất, và đường đó gần như luôn là cấu trúc câu trực tiếp “X là Y”. Ngoài ra, mô hình ưu tiên văn bản cho phép nó giải quyết truy vấn trong một câu duy nhất (Zero-Shot) thay vì phải tổng hợp câu trả lời từ 5 đoạn khác nhau.
Ứng dụng thực tế rất rõ: mở bài bằng câu khẳng định trực tiếp. Thay vì viết “Trong thế giới thay đổi nhanh chóng hiện nay, tự động hóa đang trở nên quan trọng…”, hãy viết “Tự động hóa demo là quy trình sử dụng phần mềm để…”. Câu đầu tiên phải thiết lập mối quan hệ rõ ràng giữa chủ thể và định nghĩa.
Cấu trúc hỏi-đáp ảnh hưởng thế nào đến trích dẫn AI?
Nội dung được trích dẫn có khả năng chứa dấu chấm hỏi cao gấp 2 lần (18% so với 8,9%). Khi nói “cấu trúc hỏi-đáp” (conversational writing), nghiên cứu đề cập đến sự tương tác giữa câu hỏi và câu trả lời ngay sau đó, không phải phong cách viết thân mật hay suồng sã.
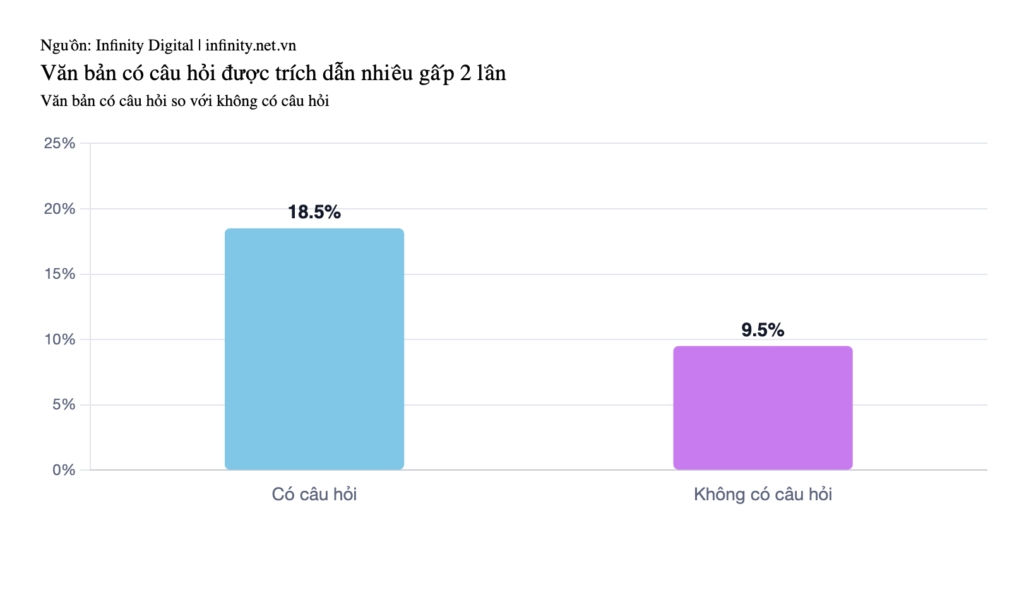
78,4% trích dẫn có chứa câu hỏi đến từ heading (thẻ H2). AI đang xử lý thẻ H2 như prompt của người dùng và đoạn văn ngay bên dưới như câu trả lời. Đây là cơ chế cốt lõi: heading đóng vai trò truy vấn, nội dung dưới heading đóng vai trò phản hồi.
Cấu trúc thắng và thua minh họa rõ sự khác biệt:
| Yếu tố | Cấu trúc thua | Cấu trúc thắng |
|---|---|---|
| Heading | <h2>Lịch sử của SEO</h2> (chủ đề trừu tượng) |
<h2>SEO bắt đầu từ khi nào?</h2> (truy vấn cụ thể) |
| Đoạn mở | “Mọi thứ bắt đầu từ những năm 90…” | “SEO bắt đầu từ…” |
Cấu trúc thắng hoạt động nhờ một kỹ thuật Infinity gọi là “entity echoing” (lặp lại thực thể). Heading hỏi về SEO, và từ đầu tiên trong câu trả lời cũng là SEO. Sự lặp lại này tạo tín hiệu rõ ràng cho mô hình rằng đoạn văn trực tiếp trả lời câu hỏi trong heading.
Mật độ thực thể (entity density) đóng vai trò gì trong AI citation?
Nội dung được trích dẫn nhiều có mật độ thực thể trung bình 20,6%, cao gấp 3-4 lần so với văn bản tiếng Anh thông thường (5-8%). Mật độ thực thể đo lường tần suất xuất hiện của danh từ riêng trong văn bản, bao gồm tên thương hiệu, công cụ, người cụ thể, sản phẩm.
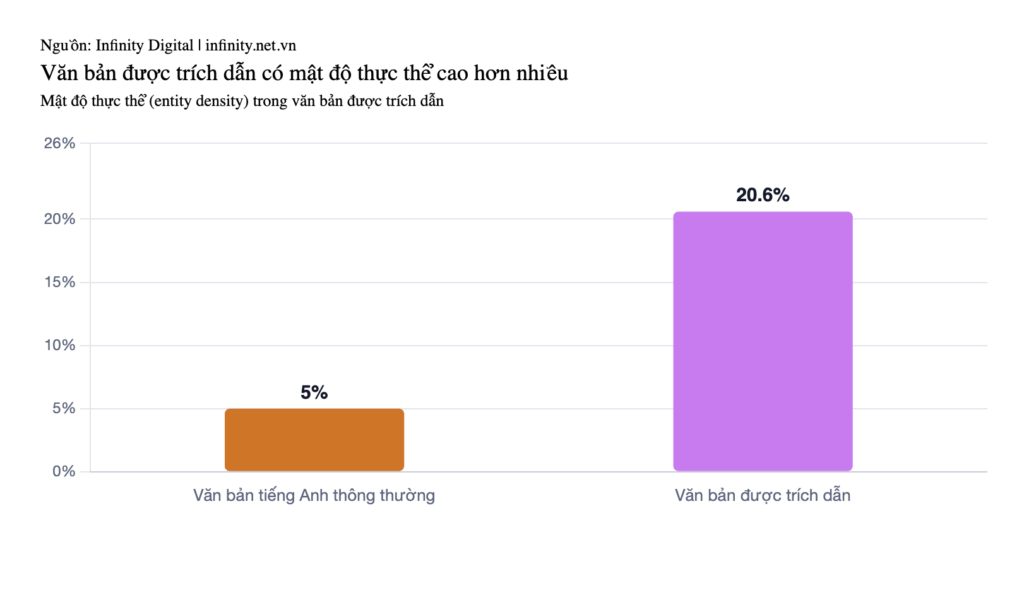
Ngưỡng 5-8% là benchmark ngôn ngữ học lấy từ các kho ngữ liệu chuẩn như Brown Corpus (1 triệu từ tiếng Anh đại diện) và Penn Treebank (văn bản Wall Street Journal). Nội dung được AI trích dẫn vượt xa ngưỡng này.
Ví dụ minh họa sự khác biệt: câu “Có nhiều công cụ tốt cho công việc này” có mật độ thực thể 0%. Câu “Các công cụ hàng đầu bao gồm Salesforce, HubSpot và Pipedrive” có mật độ khoảng 30%. LLM là hệ thống xác suất. Lời khuyên chung chung (“chọn công cụ phù hợp”) mang tính rủi ro và mơ hồ, nhưng một thực thể cụ thể (“chọn Salesforce”) có thể xác minh được. Mô hình ưu tiên các câu chứa “neo” (anchor) vì chúng làm giảm perplexity (độ nhầm lẫn) của câu trả lời.
Một câu có 3 thực thể mang nhiều “bit” thông tin hơn một câu có 0 thực thể. Vì vậy, nghiên cứu khuyến nghị: đừng ngại đề cập tên cụ thể, kể cả tên đối thủ cạnh tranh. Trong bối cảnh AI citation, entity cụ thể là tín hiệu tin cậy, không phải rủi ro thương hiệu.
Sắc thái nội dung nên nghiêng về khách quan hay chủ quan?
Nội dung được trích dẫn có điểm Subjectivity trung bình 0,47 trên thang 0,0-1,0. Subjectivity Score (điểm chủ quan) là chỉ số chuẩn trong Xử lý Ngôn ngữ Tự nhiên (NLP) đo lường mức độ ý kiến cá nhân, cảm xúc hoặc đánh giá chủ quan trong văn bản.
| Điểm | Mức độ | Ví dụ |
|---|---|---|
| 0,0 | Khách quan thuần túy | “iPhone 15 ra mắt tháng 9/2023.” |
| 0,47 | Cân bằng (vùng thắng) | “iPhone 15 sử dụng chip A16 (dữ kiện), hiệu suất chụp thiếu sáng khiến nó trở thành lựa chọn tốt cho nhà sáng tạo nội dung (phân tích).” |
| 1,0 | Chủ quan thuần túy | “iPhone 15 là kiệt tác tuyệt đẹp mà tôi yêu thích.” |
AI không muốn văn bản khô khan kiểu Wikipedia (0,1), cũng không muốn ý kiến cảm tính (0,9). Vùng tối ưu nằm ở khoảng 0,47, nơi Infinity gọi là “giọng phân tích” (analyst voice). Đây là phong cách giải thích một dữ kiện ứng dụng thế nào trong thực tế, thay vì chỉ trình bày con số rồi để đấy.
Cấu trúc lý tưởng cho mỗi đoạn văn là: một dữ kiện có thể xác minh kết hợp với một câu phân tích hoặc nhận định ứng dụng. Không phải toàn bộ là số liệu. Không phải toàn bộ là ý kiến.
Văn phong viết ở cấp độ nào được AI trích dẫn nhiều nhất?
Văn phong chuyên nghiệp cấp doanh nghiệp (business-grade writing, tương đương The Economist hay Harvard Business Review) được trích dẫn nhiều hơn. Nội dung “thắng” có điểm Flesch-Kincaid trung bình 16 (cấp đại học), trong khi nội dung “thua” đạt 19,1 (cấp nghiên cứu sinh, PhD).
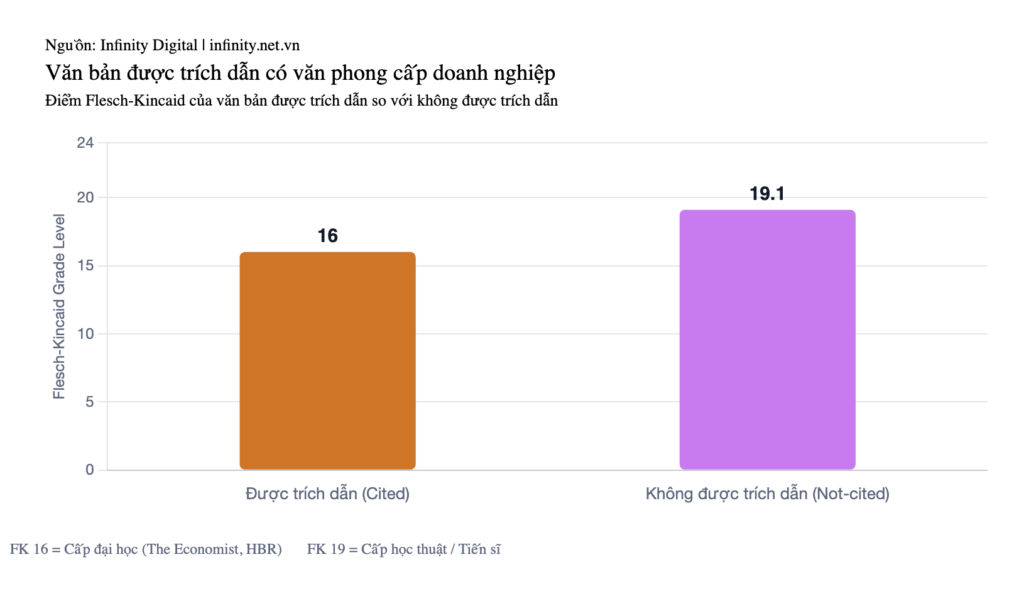
Kể cả với chủ đề phức tạp, sự phức tạp trong cách viết có thể gây hại. Điểm FK-19 đồng nghĩa câu dài, quanh co, chứa nhiều thuật ngữ đa âm tiết. AI ưu tiên cấu trúc Chủ ngữ-Động từ-Tân ngữ rõ ràng với câu ngắn đến trung bình, vì chúng dễ trích xuất dữ kiện hơn.
Phát hiện này bác bỏ quan niệm rằng AI “thưởng” cho nội dung viết đơn giản hóa quá mức (dumbing down). Ngưỡng FK-16 là cấp đại học, không phải cấp phổ thông. AI đọc tốt nhất nội dung chuyên sâu nhưng diễn đạt mạch lạc, không phải nội dung nông cạn viết cho dễ hiểu cũng không phải nội dung hàn lâm viết để “ra vẻ” sâu sắc.
Mô hình ski ramp có ý nghĩa gì đối với chiến lược nội dung?
Mô hình ski ramp phơi bày sự lệch pha giữa cách viết truyền thống (narrative writing) và cách AI thu thập thông tin (information retrieval). Trong 20 năm qua, SEO đã dạy chúng ta viết “bài hướng dẫn toàn diện” (ultimate guide) với phần mở dài, kéo insight xuyên suốt bản thảo, xây dựng kịch tính dẫn đến CTA cuối bài. Dữ liệu cho thấy phong cách này không phù hợp với AI visibility.
Thuật toán diễn giải việc “hé lộ dần” (slow reveal) như thiếu độ tin cậy. Nó ưu tiên phân loại thực thể và dữ kiện ngay lập tức. Nội dung có khả năng hiển thị cao trong AI hoạt động giống một bản tóm tắt có cấu trúc (structured briefing) hơn là một câu chuyện có mở, thân, kết theo kiểu truyền thống.
Điều này tạo ra cái Infinity gọi là “thuế minh bạch” (clarity tax) đối với người viết. Nội dung thắng cuộc trong nghiên cứu dựa vào vốn từ vựng chuyên nghiệp và mật độ thực thể cao, đồng thời front-load kết luận để thỏa mãn cả kiến trúc thuật toán lẫn thói quen đọc lướt của con người. Đây không phải viết cho robot, mà là viết cho cả hai đối tượng cùng lúc: AI và người đọc đều muốn thông tin quan trọng nhất ở đầu bài.
- AI Citation (Phần 1): Chúng ta có thể ảnh hưởng đến đầu ra của AI đến mức nào?
- AI Citation (Phần 3): AI chọn nguồn nào để trích dẫn?
- AI Citation (Phần 4): Tín hiệu viết nào thực sự ảnh hưởng đến trích dẫn AI?
- AI Citation (Phần 5): nội dung ngắn gọn, đi sâu, cụ thể được ưu tiên
- AI Citation (Phần 6): AI Citation và Brand Mention là hai hệ thống khác nhau
- AI Citation (Phần 7): Hiệu ứng của Query Fan-out
Phương pháp nghiên cứu được thực hiện như thế nào?
Toàn bộ dữ liệu nghiên cứu đến từ Gauge, với quy mô khoảng 1,2 triệu câu trả lời ChatGPT đi kèm 30 triệu trích dẫn. Mỗi URL được trích dẫn đều được thu thập nội dung tại thời điểm trả lời, đảm bảo tương quan trực tiếp giữa nội dung web thực và câu trả lời AI.
Nghiên cứu sử dụng phương pháp 3 lớp để xác định chính xác câu nào được AI trích dẫn:
| Lớp phân tích | Phương pháp | Chi tiết kỹ thuật |
|---|---|---|
| Harvester Engine | Semantic embeddings (mạng neural) | Dùng all-MiniLM-L6-v2 chuyển đổi mỗi câu trả lời AI và mỗi câu trong nguồn thành vector 384 chiều, so khớp bằng cosine similarity |
| Positional Depth | Tính vị trí chính xác | Xác định đoạn trích dẫn nằm ở vị trí phần trăm nào trong HTML (10%, 50%, 90%…) |
| Linguistic DNA | NLP so sánh “thắng” vs “thua” | Đo tỷ lệ định nghĩa, mật độ thực thể, điểm chủ quan giữa phần mở được trích dẫn và phần mở bị bỏ qua |
Bộ lọc chất lượng áp dụng ngưỡng cosine similarity 0,55 để loại bỏ các trùng khớp yếu hoặc hallucination, chỉ giữ lại trích dẫn có độ tin cậy cao. Từ 1,2 triệu kết quả ban đầu, nghiên cứu tách ra 18.012 trích dẫn cho phân tích vị trí và 11.022 trích dẫn cho phân tích ngôn ngữ.
Phần tiếp theo: Phần 3: AI chọn nguồn nào để đọc? sẽ chuyển từ câu hỏi “AI đọc ở đâu trên trang” sang “AI chọn trang nào để đọc”, phân tích sự tập trung trích dẫn theo domain, ảnh hưởng của độ dài nội dung theo từng ngành, và mô hình trang evergreen. Nếu phần này trả lời cơ chế vi mô, phần 3 sẽ trả lời cơ chế vĩ mô của hệ thống trích dẫn AI.


