


GLM-5.3-Flash là canh bạc rõ ràng của Z.ai vào phân khúc agentic giá rẻ: chỉ kém Opus 4.8 và GPT-5.6 Terra một hai điểm trên các eval coding, rồi bỏ xa họ cả chục lần về giá. Mức 84,3 trên Terminal-Bench 2.1 với giá blended khoảng 0,10 USD/1M token chính là lời chào hàng, và đây là một lời chào hàng mạnh cho coding và tự động hóa khối lượng lớn.
Tóm tắt các điểm chính
- GLM-5.3-Flash dùng kiến trúc mixture-of-experts cấu hình 320B-A18B (320 tỷ tham số tổng, 18 tỷ tham số hoạt động mỗi token), hỗ trợ context window 1M token, đa phương thức từ gốc.
- Trên DeepSWE v1.1, GLM-5.3-Flash đạt 63,4, vượt cả Claude Opus 4.8 (58,0), tăng vọt so với 46,2 của GLM-5.2.
- Giá blended (tính theo tỷ trọng sử dụng thực tế) rơi vào khoảng 0,10 USD/1M token, so với khoảng 0,90 USD của GLM-5.3.
- Đánh đổi lớn nhất là tốc độ và hạ tầng: chỉ khoảng 49 token/giây, và file checkpoint FP8 nặng tới khoảng 306 GiB, không thể tự host nhẹ nhàng.
- Qwen3.8-Flash-Next cũng ra mắt đúng cùng ngày, nên phân khúc giá rẻ đang có nhiều lựa chọn để cân nhắc ngay lúc này.
GLM-5.3-Flash là mô hình gì?
GLM-5.3-Flash là phiên bản tối ưu chi phí của Z.ai trong dòng GLM-5.3, đứng dưới đàn anh GLM-5.3 về năng lực nhưng bỏ xa về giá. Artificial Analysis chấm mô hình này 57 điểm trên intelligence index, so với 60 của GLM-5.3. Cái giá phải đánh đổi là tốc độ và hiệu năng: Flash có giá chỉ bằng khoảng một phần mười GLM-5.2, hay khoảng một phần chín giá blended của GLM-5.3, và chạy chậm hơn trên mỗi token.
Mô hình ban đầu xuất hiện dưới dạng preview ẩn danh trước khi được đặt tên chính thức, và cộng đồng đã nhanh chóng gắn cho nó mật danh “Ox Alpha”. Checkpoint công khai hiện có trên Hugging Face với tên zai-org/GLM-5.3-Flash, hỗ trợ long-context (khoảng 1M token), tool-calling và khả năng đa phương thức qua hệ sinh thái xung quanh.
Benchmark quan trọng nhất ở đây là Terminal-Bench 2.1, nơi GLM-5.3-Flash đạt 84,3 điểm, cao hơn mức 82,7 của DeepSeek-V4-Flash-0731, và chỉ kém Claude Opus 4.8 đúng 0,7 điểm. Với một mô hình có giá blended ước tính khoảng 0,10 USD/1M token, đây chính là điểm nhấn của lần ra mắt này.
Giới hạn nằm ở tốc độ và hạ tầng. Với khoảng 49 token/giây, đây không phải mô hình phù hợp cho streaming nhạy cảm về độ trễ, còn checkpoint FP8 khoảng 306 GiB loại trừ khả năng triển khai cục bộ dạng nhẹ nhàng, thông thường. Người dùng preview sớm trên r/opencodeCLI từng phản ánh thời gian chờ hàng đợi và khởi động chậm khi tải cao, dù bản GA nhiều khả năng đã cải thiện điều này.
GLM-5.3-Flash có những tính năng chính nào?
GLM-5.3-Flash được xây cho các nhà phát triển muốn hiệu năng agentic và coding mà không phải trả giá flagship.
Coding gần đạt trình độ frontier với chi phí bình dân
Có thể chạy coding agent và quy trình tự động hóa ở mức giá đủ rẻ để dùng khối lượng lớn một cách thực tế. GLM-5.3-Flash đạt 84,3 trên Terminal-Bench 2.1 và 63,4 trên DeepSWE v1.1, tăng mạnh so với mức 46,2 của GLM-5.2 trên cùng eval DeepSWE. Với người dùng thực tế, sức hút nằm ở việc chạy được các tác vụ coding vốn sẽ đắt đỏ nếu dùng mô hình cấp Opus.
Context window 1M token
Có thể nhét cả một codebase, tài liệu dài, hoặc trace agent nhiều file vào một request duy nhất. GLM-5.3-Flash hỗ trợ context window 1M token, ngang với GLM-5.3 và các window 1M của GPT-5.6 Terra, Claude Sonnet 5. Tuy nhiên một số báo cáo cộng đồng ghi nhận hiện tượng “trôi” chú ý (attention drift) ở độ dài cực lớn, vượt khoảng 700K token, một hạn chế phần lớn mô hình có context lớn khác cũng gặp phải. Khả năng nhớ lại tốt xuyên suốt hàng trăm nghìn token được ghi nhận, nhưng không nên kỳ vọng truy xuất hoàn hảo ở cuối window.
Tool calling và output có cấu trúc
Có thể tích hợp GLM-5.3-Flash vào các framework agent với function call và schema JSON bắt buộc. Mô hình đạt 78,4 trên Toolathlon và 48,8 trên AutomationBench, con số sau tăng mạnh từ mức 26,2 của GLM-5.2. Điều cần lưu ý: mức hỗ trợ khác nhau tùy nhà cung cấp. Một số gateway đánh dấu structured output là chưa hỗ trợ, cách xử lý system prompt cũng khác nhau giữa các bên host, nên có thể cần điều chỉnh schema tool và chế độ JSON cho từng endpoint.
Đầu vào đa phương thức từ gốc
Có thể đưa ảnh kèm văn bản vào để đọc biểu đồ, phân tích tài liệu và reasoning trực quan. GLM-5.3-Flash đạt 89,4% trên CharXiv-R, 80,5 trên MMVU, và 78,0 trên Chartography, cho thấy khả năng xử lý biểu đồ và tài liệu trực quan vững chắc. Khả năng đa phương thức này là tích hợp từ gốc chứ không phải gắn thêm, dù giống tool calling, mặt bằng thực tế vẫn phụ thuộc vào nhà cung cấp đang dùng.
GLM-5.3-Flash đạt điểm benchmark như thế nào?
GLM-5.3-Flash đạt 57 điểm trên Artificial Analysis Intelligence Index v4.1.1 với chi phí 0,045 USD mỗi tác vụ (đã giảm giá). Z.ai cho biết mức độ trí tuệ này trước đây tốn gấp khoảng mười lần.
DeepSWE v1.1
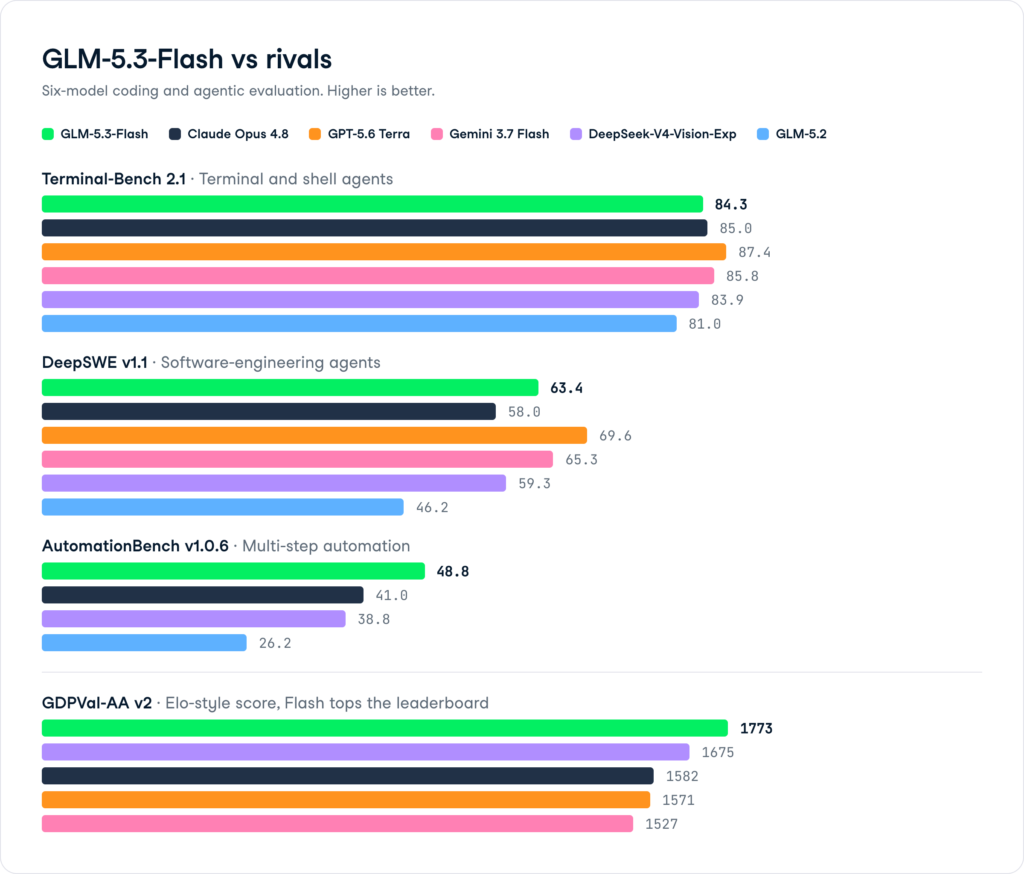
Trên benchmark agent kỹ thuật phần mềm này, GLM-5.3-Flash đạt 63,4, vượt cả Claude Opus 4.8 (58,0) và DeepSeek-V4-Vision-Exp (59,3), tăng mạnh so với 46,2 của GLM-5.2. Mô hình vẫn thua GPT-5.6 Terra (69,6) và Gemini 3.7 Flash (65,3), nhưng việc vượt qua Claude với chi phí Flash chính là điểm đáng chú ý nhất.
AutomationBench v1.0.6
GLM-5.3-Flash đạt 48,8 trên quy trình tự động hóa nhiều bước, khoảng cách lớn nhất so với Claude Opus 4.8 (41,0) và DeepSeek-V4-Vision-Exp (38,8) trong toàn bộ bộ benchmark. GLM-5.2 chỉ đạt 26,2, nên đây cũng là mức cải thiện rõ rệt nhất giữa hai thế hệ.
GDPVal-AA v2
Trên benchmark phát triển và lập trình tổng quát này, Flash dẫn đầu bảng xếp hạng với 1773 điểm, vượt DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) và Gemini 3.7 Flash (1527).
Terminal Bench 2.1
Flash đạt 84,3 trên tác vụ agent terminal và shell, chỉ đứng dưới Claude Opus 4.8 (85,0) và Gemini 3.7 Flash (85,8), thua GPT-5.6 Terra (87,4). Mô hình nhỉnh hơn GLM-5.2 (81,0) và DeepSeek-V4-Vision-Exp (83,9). Cạnh tranh tốt, nhưng chưa áp đảo.
GLM-5.3-Flash có giá bao nhiêu và truy cập ở đâu?
GLM-5.3-Flash khả dụng qua API của Z.ai và nhiều gateway bên thứ ba, gồm Baseten, Deep Infra, Venice AI và Requesty. Checkpoint công khai zai-org/GLM-5.3-Flash có trên Hugging Face để tự host.
Giá niêm yết cơ bản của Z.ai và mức khuyến mãi có thời hạn:
- Input cơ bản: 0,15 USD/1M token (khuyến mãi: 0,075 USD)
- Output cơ bản: 0,03 USD/1M token (khuyến mãi: 0,015 USD)
- Cached input: 0,50 USD/1M token (khuyến mãi: 0,25 USD)
Apidog ghi nhận giá blended theo tỷ trọng sử dụng thực tế của Flash vào khoảng 0,10 USD/1M token, so với khoảng 0,90 USD của GLM-5.3. Các gateway bên thứ ba định giá khác nhau: EmpirioLabs ở mức 0,07 USD input/0,25 USD output, Venice AI 0,09 USD/0,31 USD, và Requesty 0,14 USD/0,45 USD kèm khuyến mãi giảm 55% đến hết 9/9/2026.
Điểm cần lưu ý nằm ở thông lượng và phần cứng: Flash chạy khoảng 49 token/giây so với khoảng 86 của GLM-5.3, Artificial Analysis chấm 2/4 về tốc độ. Tự host cũng không hề nhẹ nhàng: checkpoint FP8 nặng khoảng 306 GiB chỉ riêng trọng số, chưa tính KV-cache và runtime, nên cần nhiều GPU bộ nhớ lớn (tầm trên 4 card loại 80GiB) chứ không phải một card đơn lẻ.
Nên chọn GLM-5.3-Flash hay GLM-5.3?
Lựa chọn giữa hai mô hình quy về việc đánh đổi chi phí lấy điểm intelligence index và thông lượng.
| Thuộc tính | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Intelligence index (Artificial Analysis) | 57 | 60 |
| Giá blended/1M token | Khoảng 0,10 USD | Khoảng 0,90 USD |
| Tốc độ output | Khoảng 49 token/giây | Khoảng 86 token/giây |
| Thời gian đến token đầu tiên | Khoảng 1,52 giây | Khoảng 1,57 giây |
| Terminal-Bench 2.1 | 84,3 | Không có trong ghi chú |
| Context window | 1M | 1M |
Nên chọn Flash khi chi phí trên mỗi token là ràng buộc chính và công việc là coding hoặc agentic. Nên chọn GLM-5.3 khi cần thêm điểm intelligence index và thông lượng gần gấp đôi.
GLM-5.3-Flash so với Qwen3.8-Flash-Next thì sao?
Cả hai mô hình đều ra mắt ngày 26/8/2026, cùng nhắm vào phân khúc agentic giá rẻ. GLM-5.3-Flash nhỉnh hơn Qwen3.8-Flash-Next ở benchmark duy nhất hai bên cùng chia sẻ trực tiếp (DeepSWE v1.1: 63,4 so với 58,7), nhưng hai mô hình được xây khác nhau đủ nhiều để lựa chọn phụ thuộc vào khối lượng công việc hơn là một điểm số đơn lẻ.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Kiến trúc | 320B tổng/18B hoạt động | 125B tổng/6B hoạt động |
| Context native | 1M token | 262K (1M với YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Giá input | Khoảng 0,075 USD/1M (khuyến mãi) | 0,16 USD/1M |
| Đa phương thức | Có (từ gốc) | Có (từ gốc) |
GLM-5.3-Flash kích hoạt gấp ba lần số tham số trên mỗi token, có lẽ đây là lý do dẫn đến kết quả DeepSWE và Terminal-Bench 2.1 (84,3) vượt trội. Qwen3.8-Flash-Next đáp trả bằng điểm số công bố mạnh hơn trên SWE-bench Pro (62,5) và các benchmark văn phòng, agent như CoWorkBench (73,9) và JobBench (55,7), những nơi GLM chưa công bố con số tương đương.
Về giá, GLM rẻ hơn trong thời gian khuyến mãi. Về hiệu suất tham số, Qwen làm được nhiều hơn với số tham số hoạt động nhỏ hơn. Về tự host, checkpoint nhỏ hơn của Qwen dễ chạy cục bộ hơn đáng kể.
Nếu ưu tiên coding agent và thông lượng agentic thuần túy, GLM-5.3-Flash có con số mạnh hơn ở những nơi so sánh trực tiếp được. Nếu quy trình làm việc thiên về văn phòng, đa phương thức, hoặc cần checkpoint tự host nhỏ hơn, Qwen3.8-Flash-Next đáng thử trước.
Kết luận
Nếu chi phí trên mỗi token là ràng buộc quyết định và công việc là coding hoặc agentic, GLM-5.3-Flash đáng để thử nghiệm song song với GPT-5.6 Terra và Claude Opus 4.8 trước khi cam kết. Nếu cần thêm 3 điểm intelligence index và thông lượng nhanh hơn, bản GLM-5.3 đầy đủ vẫn tồn tại vì lý do đó. Mô hình này cũng ra mắt cùng ngày với Qwen3.8-Flash-Next, nên phân khúc giá rẻ đang rất đáng để cân nhắc kỹ ngay lúc này.
Câu hỏi thường gặp
GLM-5.3-Flash so với GLM-5.3 khác nhau thế nào?
GLM-5.3-Flash đạt 57 điểm trên intelligence index của Artificial Analysis so với 60 của GLM-5.3, và chạy chậm hơn ở khoảng 49 token/giây so với khoảng 86. Khác biệt lớn nhất nằm ở chi phí: Flash có giá blended khoảng 0,10 USD/1M token so với khoảng 0,90 USD của GLM-5.3. Nên chọn Flash cho coding và công việc agentic khối lượng lớn khi chi phí là ràng buộc chính.
Có thể truy cập GLM-5.3-Flash ở đâu?
GLM-5.3-Flash khả dụng qua API chính thức của Z.ai và các gateway bên thứ ba gồm Baseten, Deep Infra, Venice AI, EmpirioLabs và Requesty. Checkpoint công khai có trên Hugging Face với tên zai-org/GLM-5.3-Flash để tự host, dù trọng số FP8 nặng khoảng 306 GiB và cần nhiều GPU bộ nhớ lớn.
Giá của GLM-5.3-Flash là bao nhiêu?
Giá niêm yết cơ bản của Z.ai là 0,15 USD/1M input token và 0,03 USD/1M output token, khuyến mãi có thời hạn giảm còn một nửa xuống 0,075 USD và 0,015 USD. Cached input là 0,50 USD/1M giá gốc, 0,25 USD khi khuyến mãi. Các gateway bên thứ ba dao động từ EmpirioLabs 0,07 USD/0,25 USD đến Requesty 0,14 USD/0,45 USD.
GLM-5.3-Flash coding tốt đến mức nào?
Mô hình đạt 84,3 trên Terminal-Bench 2.1, gần với Claude Opus 4.8 (85,0) và kém GPT-5.6 Terra (87,4), cộng 63,4 trên DeepSWE v1.1, tăng từ mức 46,2 của GLM-5.2. Con số này vượt mức 82,7 đo được cho DeepSeek-V4-Flash-0731 trên cùng benchmark terminal, và với mức giá rẻ hơn nhiều.
Giới hạn chính của GLM-5.3-Flash là gì?
Tốc độ là giới hạn đầu tiên: khoảng 49 token/giây output và điểm tốc độ 2/4 từ Artificial Analysis khiến mô hình kém phù hợp cho streaming nhạy cảm về độ trễ. Tự host cần nhiều GPU bộ nhớ lớn vì checkpoint FP8 nặng khoảng 306 GiB. Báo cáo cộng đồng cũng ghi nhận hiện tượng trôi chú ý vượt khoảng 700K token và mức hỗ trợ structured output khác nhau tùy nhà cung cấp.


