

Tóm tắt các điểm chính:
- Cuộc đua mô hình frontier cuối năm 2026 phần lớn là cuộc đua về giá hơn là năng lực thô. Riêng tháng 9, cả GPT-6 Astra lẫn Claude Fable 5.1 đều niêm yết 10 USD/50 USD trên 1M token, không có gói miễn phí.
- Chỉ khoảng 8 tỷ tham số kích hoạt cho input và 16 tỷ cho output trên tổng 552 tỷ tham số, đây chính là lý do chi phí phục vụ giữ ở mức thấp trong khi vẫn đạt điểm ngang frontier trên một số benchmark.
- Trên Terminal-Bench 2.1, mô hình đạt 90,6 điểm, tăng mạnh so với 82,7 của thế hệ trước DeepSeek-V4-Flash-0731.
- DeepSeek thu nhỏ KV cache còn khoảng một phần tư kích thước của V4 Flash trước đó, giảm dung lượng bộ nhớ cần thiết và phục vụ context dài rẻ hơn.
- Giá off-peak giảm còn một nửa giá peak (0,15 USD/0,60 USD), nhưng cần có logic lên lịch tác vụ để thực sự tận dụng được mức giảm giá này.
DeepSeek V4.1 Flash là mô hình gì?
DeepSeek V4.1 Flash là mô hình mới nhất trong dòng Flash của DeepSeek, được định vị là tầng hiệu quả, thông lượng cao thay vì một mô hình nặng ký cấp nghiên cứu. Đây là kiến trúc mixture-of-experts (MoE) thưa với 552 tỷ tham số tổng, trong đó chỉ khoảng 8 tỷ tham số hoạt động mỗi token cho input và 16 tỷ cho output. Chính cơ chế kích hoạt thưa này giữ chi phí phục vụ ở mức thấp trong khi vẫn đạt điểm số ngang tầm frontier trên một số benchmark.
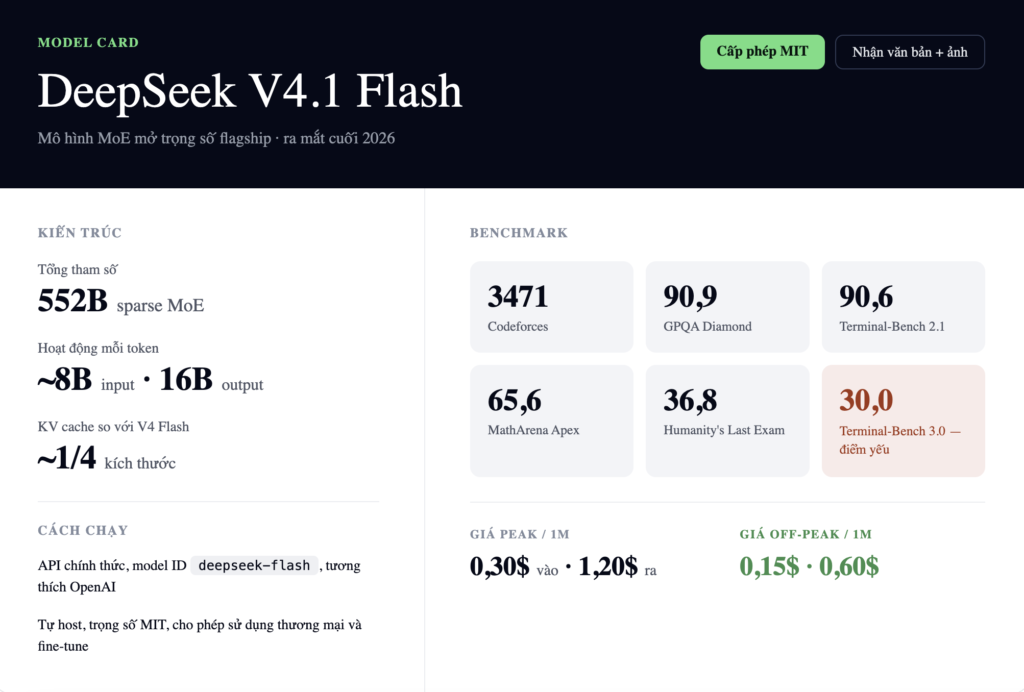
Thay đổi lớn nhất so với thế hệ trước nằm ở hiệu quả. DeepSeek thu nhỏ KV cache còn khoảng một phần tư kích thước của V4 Flash trước đó, giảm dung lượng bộ nhớ cần dùng và cho phép mô hình phục vụ context dài với chi phí rẻ hơn. Công ty cũng cho biết V4.1 Flash vượt trội V4 Pro 0813 cũ hơn về hiệu năng, chi phí, tốc độ và tổng thời gian, và V4 Pro đang bị loại bỏ dần theo đó.
Về mặt benchmark, con số nổi bật nhất là Terminal-Bench 2.1 ở mức 90,6. Khi đánh giá DeepSeek-V4-Flash-0731 trước đó, mô hình chỉ đạt 82,7 trên cùng benchmark, nên V4.1 Flash là một bước tiến thực sự về công việc terminal agentic trong cùng một dòng sản phẩm.
DeepSeek V4.1 Flash có những tính năng chính nào?
Bộ tính năng của V4.1 Flash xoay quanh hai ý tưởng: chạy rẻ, và giữ mở.
Trọng số mở, tự host được.
V4.1 Flash phát hành theo giấy phép MIT, giấy phép dễ dãi phổ biến nhất, cho phép sử dụng thương mại, phân phối lại và fine-tune mà không có ngưỡng doanh thu nào.
Với các đội có ràng buộc về quyền riêng tư dữ liệu, điều này nghĩa là có thể chạy mô hình hoàn toàn trên phần cứng riêng thay vì gửi request đến API của DeepSeek.
Đánh đổi là giấy phép MIT chuyển trách nhiệm về an toàn, fine-tune và tối ưu inference sang chính người dùng.
Khi chạy V4-Flash-0731 trước đó cục bộ, cần tới ba GPU NVIDIA A100 80GB ở mức lượng tử hóa Q8, nên tự host chỉ khả thi khi có sẵn bộ nhớ GPU đáng kể.
Đầu vào ảnh từ gốc.
V4.1 Flash nhận ảnh trực tiếp làm đầu vào, không cần adapter thị giác riêng hay bước tiền xử lý. Có thể đưa screenshot, biểu đồ hoặc bản scan tài liệu vào cùng một request với văn bản, hữu ích cho pipeline nặng về tài liệu và quy trình agent UI. Đầu vào đa phương thức từ gốc ở mức giá này khá hiếm gặp.
Trên đánh giá ZeroBench-main có dùng tool, mô hình đạt 49,0 điểm, cho một tín hiệu tương đối về khả năng reasoning trên đầu vào trực quan.
KV cache thu nhỏ giúp context dài rẻ hơn.
KV cache trong V4.1 Flash chỉ bằng khoảng một phần tư kích thước của V4 Flash trước đó, giảm chi phí bộ nhớ khi giữ context dài trong một phiên phục vụ.
Kết hợp với giá cache-hit input chỉ 0,006 USD trên 1M token ở mức peak, việc tái sử dụng context trở nên cực rẻ.
Nếu thường xuyên gửi lại cùng một system prompt hoặc tài liệu qua nhiều request, phần được cache gần như không tốn phí.
Chế độ giá peak và off-peak.
DeepSeek vận hành cơ chế giá hai tầng, trong đó giá off-peak bằng một nửa giá peak, với mục đích công bố là đẩy các khối lượng công việc dạng batch và đã lên lịch vào khung giờ off-peak.
Điều này biến mức 0,30 USD/1,20 USD thành 0,15 USD/0,60 USD trên 1M token nếu có thể canh giờ chạy tác vụ.
Lưu ý về mặt vận hành: khối lượng công việc chạy liên tục sẽ khó dự đoán chi phí hơn, và để tận dụng được mức giảm giá cần xây dựng và duy trì logic lên lịch tác vụ riêng.
DeepSeek V4.1 Flash đạt điểm benchmark như thế nào?
Thế mạnh lớn nhất của V4.1 Flash nằm ở các benchmark agentic và reasoning, nơi mô hình đạt điểm gần ngang frontier với chi phí chỉ bằng một phần nhỏ. Điểm số giảm mạnh trên các đánh giá agentic khó nhất, điều này đáng lưu ý trước khi giao cho mô hình các tác vụ dài hạn.
Coding và quy trình agentic.
V4.1 Flash đạt 90,6 trên Terminal-Bench 2.1, đo mức độ hoàn thành tác vụ nhiều bước trong môi trường terminal. Để so sánh quy mô, DeepSeek-V4-Flash-0731 chỉ đạt 82,7 trên cùng benchmark, còn GPT-5.6 Terra đạt 87,4. Bức tranh thay đổi ở các đánh giá agentic khó hơn: mô hình tụt xuống 30,0 trên Terminal-Bench 3.0, cho thấy xử lý tốt các tác vụ terminal tiêu chuẩn nhưng gặp khó khăn với bộ đánh giá agentic đòi hỏi cao hơn. Điểm Codeforces 3471 báo hiệu khả năng lập trình thi đấu mạnh.
Reasoning và tác vụ tri thức.
Trên GPQA Diamond, bộ câu hỏi khoa học cấp sau đại học được thiết kế để khó trả lời chỉ bằng trí nhớ, V4.1 Flash đạt 90,9, một kết quả mạnh cho một mô hình ở tầng giá này, đưa mô hình vào cùng cuộc trò chuyện với các mô hình frontier đắt hơn nhiều.
Trên Humanity’s Last Exam (HLE), benchmark cấp chuyên gia cố tình khắc nghiệt, mô hình đạt 36,8, hoặc 39,1 với cấu hình có gắn dấu sao. Để so sánh, các đánh giá khoa học agentic như Terminal-Bench-Science 0.1 cho Claude Fable 5.1 đạt 52,6% trước các đối thủ khó hơn, nên V4.1 Flash không dẫn đầu các eval chuyên gia khó nhất, nhưng cũng không hề tệ.
Reasoning toán học.
V4.1 Flash đạt 65,6 trên MathArena Apex, benchmark toán học thi đấu thưởng cho reasoning ký hiệu nhiều bước.
Đây là một trong những kết quả mạnh nhất của mô hình, gợi ý đây là lựa chọn hợp lý cho khối lượng công việc định lượng và nặng về toán.
Một điểm số ở khoảng giữa 60 tại đây quan trọng với bất kỳ ai xây công cụ cần reasoning số học và đại số đáng tin cậy, vì nhiều mô hình rẻ hơn thường sụp đổ đúng ở các tác vụ này.
Nên chọn cách triển khai nào?
Quyết định ở đây ít liên quan đến biến thể mô hình mà nhiều hơn đến cách triển khai V4.1 Flash, vì cùng một bộ trọng số chạy được theo ba cách. Lựa chọn phụ thuộc vào khả năng dự đoán chi phí, quyền riêng tư dữ liệu, và việc có thể lên lịch tác vụ hay không.
DeepSeek cũng đang chạy một giai đoạn di chuyển: từ 12:00 giờ Bắc Kinh ngày 14/9/2026 cho đến khi V4.1 Pro ra mắt trong tương lai, các request đến endpoint cũ sẽ được chuyển hướng, đẩy người dùng hiện tại sang dòng V4.1. Nếu vẫn đang dùng V4 Pro 0813, mô hình đó đang bị loại bỏ dần, nên lên kế hoạch chuyển sang V4.1 Flash ngay từ bây giờ.
| Trường hợp sử dụng | Hướng triển khai khuyến nghị | Vì sao |
|---|---|---|
| Coding agent khối lượng lớn, chạy liên tục | API chính thức, giá peak | 0,30 USD/1,20 USD trên 1M đã rẻ hơn nhiều đối thủ frontier, không tốn công lên lịch |
| Tác vụ reasoning hoặc toán batch quy mô lớn | API chính thức, giá off-peak | Off-peak giảm một nửa giá xuống 0,15 USD/0,60 USD trên 1M nếu có thể lên lịch chạy |
| Dữ liệu nhạy cảm hoặc độc quyền | Tự host trọng số MIT | Giữ inference trên phần cứng riêng, cần bộ nhớ GPU thực sự |
| Tái sử dụng context nhiều | API kèm prompt caching | Cache-hit input chỉ 0,006 USD trên 1M khiến context lặp lại gần như miễn phí |
DeepSeek V4.1 Flash có giá bao nhiêu và truy cập ở đâu?
V4.1 Flash là một trong những mô hình có năng lực rẻ nhất hiện có, đặc biệt ở mức off-peak.
| Mức phí | Peak | Off-peak |
|---|---|---|
| Input trên 1M token | 0,30 USD | 0,15 USD |
| Output trên 1M token | 1,20 USD | 0,60 USD |
| Cache-hit input trên 1M token | 0,006 USD | Chưa công bố |
Để so sánh, GPT-6 Astra và Claude Fable 5.1 đều tính phí 10 USD trên 1M input và 50 USD trên 1M output, nên V4.1 Flash rẻ hơn khoảng 30 lần về input và 40 lần về output ở mức peak. Mô hình đang bị loại bỏ dần, V4 Pro 0813, có giá 0,435 USD trên 1M input và 0,87 USD trên 1M output với context 1M token. Vì DeepSeek khẳng định V4.1 Flash vượt trội V4 Pro về hiệu năng, chi phí và tốc độ, gần như không có lý do để tiếp tục dùng mô hình cũ.
V4.1 Flash khả dụng qua API chính thức của DeepSeek, và trọng số MIT được công bố để tự host. Từ 14/9/2026, các request đến endpoint cũ sẽ được chuyển hướng sang dòng V4.1 cho đến khi V4.1 Pro ra mắt.
Truy cập DeepSeek V4.1 Flash như thế nào?
V4.1 Flash vừa là một mô hình API vừa là một bản phát hành trọng số mở, nên có hai cách tiếp cận. Trên API, model ID thường được liệt kê là deepseek-flash, endpoint tương thích OpenAI, nghĩa là phần lớn code client OpenAI hiện có chỉ cần đổi base URL là chạy được.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Để tự host, trọng số cấp phép MIT cho phép sử dụng thương mại, phân phối lại và fine-tune mà không có ngưỡng doanh thu. Khi chạy V4-Flash-0731 trước đó cục bộ với Unsloth Studio, cần tới ba GPU NVIDIA A100 80GB ở mức lượng tử hóa Q8, nên nên dự trù phần cứng tương tự cho thiết lập full-precision.
Kết luận
Đáng cân nhắc chuyển sang mô hình này cho coding agent và tác vụ reasoning theo batch, đặc biệt nếu có thể lên lịch chạy off-peak. Điểm trừ xuất hiện khi nhìn vào mức 30,0 trên Terminal-Bench 3.0, cho thấy mô hình chao đảo trên các tác vụ agentic khó nhất, và cơ chế tính phí peak/off-peak đòi hỏi công sức lên lịch mà người dùng phải tự chịu trách nhiệm.
Câu hỏi thường gặp
DeepSeek V4.1 Flash so với V4 Pro 0813 khác nhau thế nào?
DeepSeek khẳng định V4.1 Flash vượt trội V4 Pro 0813 về hiệu năng, chi phí, tốc độ và tổng thời gian, và V4 Pro đang bị loại bỏ dần theo đó. V4.1 Flash có giá 0,30 USD/1,20 USD trên 1M token ở mức peak so với 0,435 USD/0,87 USD của V4 Pro, và từ 14/9/2026, các request đến endpoint cũ sẽ được chuyển hướng sang dòng V4.1.
Có thể truy cập DeepSeek V4.1 Flash ở đâu?
Có thể truy cập qua API chính thức của DeepSeek với model ID thường được liệt kê là deepseek-flash, chạy trên endpoint tương thích OpenAI. Vì trọng số cấp phép MIT, cũng có thể tự host mô hình trên phần cứng riêng.
DeepSeek V4.1 Flash giá bao nhiêu?
Giá peak là 0,30 USD trên 1M input token và 1,20 USD trên 1M output token, cache-hit input ở mức 0,006 USD trên 1M. Giá off-peak giảm một nửa mức tiêu chuẩn xuống 0,15 USD input và 0,60 USD output trên 1M token, nên lên lịch chạy batch off-peak giúp giảm khoảng một nửa hóa đơn.
DeepSeek V4.1 Flash có phải mã nguồn mở không?
V4.1 Flash phát hành trọng số mở theo giấy phép MIT, cho phép sử dụng thương mại, phân phối lại và fine-tune mà không có ngưỡng doanh thu. Đánh đổi là phải tự chịu trách nhiệm về an toàn, fine-tune và tối ưu inference khi tự host.
DeepSeek V4.1 Flash phù hợp nhất để dùng cho việc gì?
Phù hợp tốt với coding agent khối lượng lớn, reasoning theo batch, và khối lượng công việc nặng về toán, đạt 90,6 trên Terminal-Bench 2.1, 90,9 trên GPQA Diamond, và 65,6 trên MathArena Apex. Mô hình yếu hơn ở các tác vụ agentic khó nhất, tụt xuống 30,0 trên Terminal-Bench 3.0, nên kém phù hợp hơn cho công việc agent tự động dài hạn.